• Home

    Escolha seu Plano

    Carreiras Alura

    Evolua com profundidade técnica, direção clara e aplicação prática.

    Jornadas guiadas do básico ao avançado com checkpoints práticos, desenhadas para quem busca profundidade e protagonismo técnico.

    Iniciante

    Comece do zero com uma trilha clara e progressiva.

    Fundamentos práticos para dar os primeiros passos com segurança e construir uma base sólida.

    Intermediário

    Continue sua evolução com cursos que conectam fundamentos, ferramentas e prática profissional. Ganhe autonomia, e avance para projetos mais completos.

    Avançado

    Aprofunde temas técnicos e estratégicos para enfrentar desafios mais complexos. Explore boas práticas, arquitetura, performance com visão profissional.

    Cursos

    Ver mais cursos de Back-end
    • Pensamento computacional: fundamentos da computação e lógica de programação
    • Lógica de programação: mergulhe em programação com JavaScript
    • DDD: fundamentos do design orientado a domínio
    • ASP.NET: autenticação e autorização em APIs e aplicações web
    • Microsserviços: migração de monólitos e modularização

    Cursos

    Ver mais cursos de Dados
    • Python para Dados: primeiros passos
    • Excel: domine o editor de planilhas
    • Engenharia de Dados: Orquestração de Pipelines com Apache Airflow
    • Power BI Desktop: construindo meu primeiro dashboard
    • Governança e Arquitetura de Dados

    Cursos

    Ver mais cursos de Inteligência Artificial
    • IA: Explorando o Potencial da Inteligência Artificial Generativa
    • Engenharia de Prompt: Criando Prompts Eficazes para IA Generativa
    • Claude para Análise de Dados: prompts, integrações e automações
    • Agno: criando agentes e sistemas multiagente
    • Engenharia de software na era da IA: segurança de aplicações com agentes, MCPs e código gerado por IA

    Cursos

    Ver mais cursos de Front-end
    • HTML e CSS: ambiente, estrutura e estilo
    • React: realizando testes avançados com Jest e Testing Library
    • React: integrando TypeScript em projetos
    • JavaScript: aprendendo a programar
    • React: aplicando arquiteturas de Micro frontends

    Cursos

    Ver mais cursos de DevOps
    • Sistema Operacional Linux: fundamentos e administração prática
    • Containers e Docker: empacotamento, isolamento e gestão
    • Redes: dos conceitos iniciais à criação de uma intranet
    • Linux: gerenciando diretórios, arquivos, permissões e processos
    • Cibersegurança: Fundamentos e práticas integradas

    Cursos

    Ver mais cursos de UX & Design
    • UX Research: mapeando a experiência da pessoa usuária
    • UX/UI Design: Entregando produtos digitais com IA
    • UI Design: Prototipação e animações interativas
    • Figma: Conhecendo o programa
    • Product Design: métricas e ciclo de vida do produto

    Cursos

    Ver mais cursos de Gestão & Negócios
    • Canva: Criação de landing pages e e-mail marketing
    • Agilidade: como ela pode ajudar a criar um time de alta performance
    • Google Analytics 4: Extrair insights e configurar eventos
    • Management 3.0: gerencie o ambiente, não as pessoas
    • Automação de processos com n8n: Inteligência de dados para Marketing

    Cursos

    Ver mais cursos de Mobile
    • React Native: Estilização e Layouts com Flexbox e StyleSheet
    • Flutter: Graphql e suporte offline
    • Android com Gemini: Trabalhando com textos e imagens na IA
    • Dart: trabalhando com orientação a objetos
    • React Native: Dominando Listas com FlatList e ScrollView

    Carreiras

    Ver mais carreiras
    • Especialista em IA
    • Engenharia de IA
    • Ai native software engineering
    • Arquitetura de Soluções com IA
    • AI Product Design
    • Engenharia de Machine Learning
    • Desenvolvimento Front-End React
    • Engenharia de Dados
    • Cloud Security
    • Social Media Marketing
    • Engenharia de Agentes de IA

    Cursos

    • Engenharia de Prompt: Prompts Eficazes para IA Generativa
    • Claude Code: Criando sua Primeira Aplicação
    • Python: Crie sua Primeira Aplicação
    • Git e GitHub: Compartilhando e Colaborando
    • N8N: Fluxos de Trabalho Avançados

    Cursos

    • Copilot Studio: Solução Multiagentes
    • Padrões de API HTTP e Modelagem de APIs
    • Python para Análise de Dados com SQL
    • Docker: Criando e Gerenciando Containers
    • Design com IA: Otimizando o Processo Criativo

    Cursos

    • Model Context Protocol (MCP)
    • Spec-Driven Development: Dev Assistido por Agentes
    • Arquitetura de Sistemas Distribuídos com Java
    • Governança de Modelos e Reprodutibilidade
    • Pentest: Vulnerabilidades em Aplicações Web

    Escolha seu Plano

    Skills & Go

    O Skills & Go é para Tech Leads, Product Managers, estrategistas e early adopters que transformam ideias em soluções de alto impacto. Em cursos ao vivo e 100% online, você domina a nova era da IA em tempo real.

    Aulas ao vivo

    Saiba mais
    • Agentic Engineering: orquestre múltiplos agentes com confiabilidade
    • Building AI Products: transforme ideias em produtos reais com IA
    • AI Data Strategy: transforme dados em decisões estratégicas com IA

    Escolha seu Plano

    Eventos Alura

    Nossos eventos são pensados para quem quer estar à frente das mudanças em tecnologia, IA e inovação. Em experiências presenciais, você acompanha tendências e se conecta com especialistas que estão moldando o futuro.

    Próximos eventos

    • Imersão Engenharia de Software: Dev na Era da IA
    • IA Conference
    • Alura Signals
  • Talent Lab
  • IA

    Escolha seu Plano

    Conteúdos gratuitos

    Explore conteúdos gratuitos para aprender tecnologia no seu ritmo. Encontre artigos com conteúdos técnicos para aprender na prática, notícias para acompanhar as principais tendências do mercado e o Alura Labs, com análises e reflexões de especialistas sobre tecnologia, IA e carreira.

    Conteúdos gratuitos

    • Artigos
    • Notícias
    • Alura Labs
  • Para Empresas
Ver planos
Links principais
  • Planos e Promoções
  • Links complementares do menu mobile
  • Talent lab
  • Inteligência Artificial
  • Pós Graduações
  • Para Empresas
  • Sobre a Alura
  • Grupo Alun
  • Entrar
    • Home
    • Carreiras
    • Skills & Go
    • Talent Lab
    • Inteligência Artificial
    • Pós Graduações
    • Artigos
    • Sobre a Alura
    • Grupo Alun
    LoginContato
    • LinkedIn
    • Instagram
    • YouTube
    1. Página inicial
    2. Dados
    3. Iniciando um projeto Spark no Google Colab

    Iniciando um projeto Spark no Google Colab

    7 min7 minutos de leitura

    7 min7 minutos de leitura

    Publicado: 10/01/2022

    Última atualização: 09/12/2025

    1. Hadoop e Spark
    2. Quais as vantagens do Spark?
    3. Conclusão

    Quando perguntamos para uma pessoa, que já deu seus primeiros passos no universo de Data Science e Machine Learning, quais as bibliotecas que ela utilizaria para carregar e processar os dados, provavelmente ela diria SKlearn e Pandas. Ambas resolvem muito bem todas as tarefas que precisamos quando estamos lidando com uma quantidade de dados pequena.

    E quando passamos para um cenário de dados mais volumosos (na casa dos milhões, bilhões ou até mais)? Será que o Pandas vai conseguir processar tudo isso? Uma vez que o Pandas faz uso de memória RAM da máquina para processar os dados, a resposta geralmente é: não vai conseguir. Então, o que uma pessoa cientista de dados pode fazer neste momento?

    Hadoop e Spark

    Pensando em resolver este problema, surgiram soluções como o Hadoop e o Spark. O que eles fazem é tornar possível o processamento de grandes quantidades de dados através do processamento distribuído. O Hadoop, o mais antigo dos dois, foi criado em 2008 e é composto por três camadas principais: a de processamento (MapReduce), a de armazenamento (Hadoop Distributed File System - HDFS) e a de gerenciamento de recursos (YARN). Isso permite o processamento de Big Data.

    Muito legal! Mas, se o Hadoop já resolve todo o problema de processamento de dados, qual a motivação para utilizar o Spark? Isto está relacionado com o funcionamento do Hadoop. A cada operação que executa, ele precisa ler os dados e depois gravá-los de volta no armazenamento físico após o processamento. A leitura e gravação frequentes no disco geram um gargalo enorme em toda a operação que, mesmo rodando em paralelo, vai ficar limitada.

    Spark resolve isso melhorando o modelo de programação MapReduce e reaproveitando todas as outras soluções (YARN e HDFS). Outra diferença importante em relação ao Hadoop é que o Spark trabalha com os dados em memória e não com leituras e gravações constantes em disco. Com isso, ele apresenta uma performance bastante superior ao Hadoop, podendo chegar a um desempenho até 100 vezes maior.

    Convencidos(as) de que o Spark é a melhor opção para trabalhar com seus dados? Então vamos aprender como utilizar o Spark no seu projeto no Colab.

    Instalando o Spark no Google Colab

    Iremos aprender duas maneiras de instalar o Spark no Colab. A primeira é instalando o pacote PySpark através de um gerenciador de pacotes e a segunda é fazendo o download dos arquivos necessários para Spark, Hadoop e Java.

    Segundo a documentação no site PyPI, que é o gerenciador de pacotes Python, temos que:

    O pacote Python para Spark não se destina a substituir todos os outros casos de uso. Esta versão do pacote é adequada para interagir com um cluster existente (seja Spark standalone, YARN ou Mesos), mas não contém as ferramentas necessárias para configurar seu próprio cluster Spark standalone. Você pode baixar a versão completa do Spark na página de downloads do Apache Spark.

    De maneira geral, ao utilizar somente o PySpark não é possível configurar o cluster no Spark Standalone. Então, qual devemos instalar? Inicialmente, é melhor instalar a versão do pacote PySpark, porque é mais fácil e vai atender quem está começando no mundo do Spark.

    No entanto, é importante aprender o segundo método, pois ele será necessário em projetos com um grande volume de dados e com a necessidade de gerenciamento de recursos de processamento e memória, no qual será preciso acompanhar e gerenciar todos os processos executados pelo Spark.

    Instalando o pacote PySpark

    Para instalar o PySpark no Colab, basta digitar o comando !pip install, o nome do pacote pyspark e a versão, adicionando o sufixo ==3.3.1 ao nome do pacote.

    Fique sempre atento(a) à versão recomendada para o projeto que está trabalhando.

    !pip install pyspark==3.3.1
    

    E é isso! Apenas com esse comando você consegue começar a trabalhar com o PySpark.

    Instalando a ferramenta Spark

    Agora, vamos seguir para o segundo método de instalação do Spark que envolve mais etapas e pré-requisitos, mas também permite um maior gerenciamento dos recursos para o Spark.

    Primeiro, vamos precisar instalar um kit de desenvolvimento java (JDK) que vai permitir rodar código na linguagem Scala e nas máquinas virtuais Java (JVM), que é como o Spark foi construído. Para isso, utilizaremos o comando:

    !apt-get install openjdk-8-jdk-headless -qq > /dev/null
    

    Depois vamos baixar, através da ferramenta wget, os arquivos do Spark na máquina virtual do Google. Nesse caso, optamos pela versão 3.3.1 do Spark e a versão 3 do Hadoop. (Para buscar por outras versões podemos consultar a pagina oficial do Spark).

    !wget -q https://dlcdn.apache.org/spark/spark-3.3.1/spark-3.3.1-bin-hadoop3.tgz
    

    O próximo passo vai ser descompactar o arquivo que fizemos download.

    !tar xf spark-3.3.1-bin-hadoop3.tgz
    

    Por fim podemos instalar o pacote findspark que será responsável por tornar o PySpark uma biblioteca possível de ser importada regularmente.

    !pip install -q findspark
    

    Agora podemos passar para o Python e definir as variáveis de ambiente para cada utilitário. Basicamente, explicaremos para o computador onde estão os programas que vamos utilizar. No nosso caso, esses programas são o Java e o Spark.

    import os
    os.environ["JAVA_HOME"] = "/usr/lib/jvm/java-8-openjdk-amd64"
    os.environ["SPARK_HOME"] = "/content/spark-3.3.1-bin-hadoop3"
    

    Com as variáveis de ambiente definidas, podemos utilizar o findspark que vai permitir a importação dos pacotes necessários para utilizar o PySpark.

    import findspark
    findspark.init()
    

    Pronto! Conseguimos instalar o Spark e utilizar o PySpark.

    Testando o PySpark

    Independente do método, conseguimos testar a instalação da mesma maneira. Podemos, por exemplo, importar o SparkSession do módulo pyspark.sql.

    from pyspark.sql import SparkSession
    

    E, finalmente, criarmos a nossa seção Spark que nada mais é que a API que vamos utilizar para trabalhar com o Spark. Ela vai cuidar de toda a parte de gerenciamento dos nós do processamento em paralelo.

    spark = SparkSession.builder \
        .master('local[*]') \
        .appName('Iniciando com Spark') \
        .config('spark.ui.port', '4050') \
        .getOrCreate()
    

    Executando apenas a variável spark em uma célula veremos algumas informações sobre a sessão Spark criada.

    spark
    

    Teremos como retorno, o nome da nossa sessão Iniciando com Spark, a versão utilizada v3.1.1 e a configuração local com todos os cores disponíveis local[*].

    SparkSession - in-memory
    SparkContext
    Spark UI
    Version
    v3.1.1
    Master
    local[*]
    AppName
    Iniciando com Spark
    

    Feito isso, você terá acesso a todas as operações do Spark prontas para serem utilizadas.

    Banner do Guia Tático Alura sobre carreira em tecnologia, destacando o mapa da carreira tech. A imagem convida a explorar diferentes caminhos profissionais, comparar possibilidades e encontrar a próxima fase da carreira na área de tecnologia, com chamada “Explore o mapa”.

    Quais as vantagens do Spark?

    É importante destacar que cada uma das ferramentas tem suas vantagens e desvantagens e é necessário refletir quando utilizar cada uma delas. O Pandas funciona muito bem para bases pequenas. Já o Hadoop pode ser a melhor escolha com bases grandes em que a perda de performance não seja muito grande.

    Para o Spark pode ser uma escolha sua para quando estiver trabalhando com muitos dados que precisem de alta performance ou até com dados em streaming. Abaixo temos um gráfico de um estudo Benchmarking Apache Spark on a Single Node Machine comparando as performances do Pandas e do PySpark.
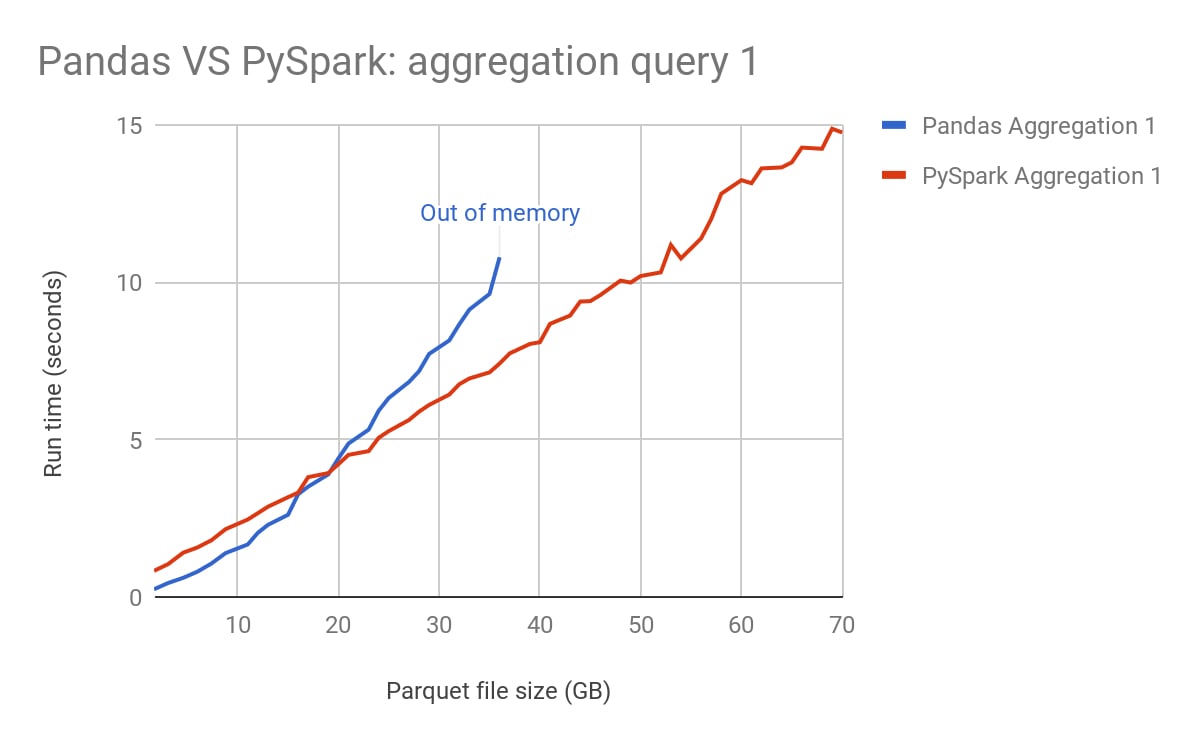
    Gráfico mostrando a agregação feita com o Pandas e o PySpark. No eixo y temos o tempo de execução em segundos. No eixo x temos o tamanho do arquivo em Gigabytes. A agregação do Pandas é representada em azul, parte do zero e está em crescimento. A agregação do PySpark é representada por uma linha vermelha, que também parte do zero e está em crescimento. A linha vermelha fica acima da linha azul até quando elas se cruzam no ponto onde o tamanho do arquivo é de 20 GB e então a linha azul fica acima da vermelha. A linha azul é interrompida próximo aos 35GB e temos a mensagem “sem memória”, enquanto a linha vermelha do Spark continua crescendo até o final do gráfico.

    No gráfico podemos observar que o Pandas apresenta melhor performance para poucos dados e que o Pyspark é superior quando temos muitos dados.

    Conclusão

    Neste artigo, aprendemos como instalar os pré-requisitos para rodar o Spark no ambiente do Google Collaboratory. Aqui na Alura temos diversos conteúdos que vão apresentar várias possibilidades com o Spark, desde trabalhar com Streaming até Machine Learning.

    Se quiser conhecer mais sobre a história do Spark e do Big Data, temos o Alura+ Big Data com Apache Spark. Para aprofundar ainda mais na prática do Spark, temos a formação Apache Spark com Python.


    Créditos:

    • Autor: Igor Nascimento Alves
    • Co-autores: Bruno Raphaell e Marcus Almeida
    • Produção técnica: Rodrigo Dias
    • Produção didática: Morgana Gomes
    Banner do Guia Tático Alura sobre carreira em tecnologia, destacando o mapa da carreira tech. A imagem convida a explorar diferentes caminhos profissionais, comparar possibilidades e encontrar a próxima fase da carreira na área de tecnologia, com chamada “Explore o mapa”.

    Avalie este artigo

    • Foto de Igor Nascimento Alves

      Autor(a)

      Igor Nascimento Alves

      Sou graduado em Ciência da Computação. Atuo como instrutor de Data Science e Machine Learning no Grupo Alura, tendo como principais interesses na tecnologia: criação de modelos e análise de dados. Nas horas vagas assisto e analiso dados de basquete e adoro ouvir podcasts de humor como Nerdcast e Jujubacast.

    Explore por tópico

    • Back-end
    • Dados
    • DevOps
    • Front-end
    • Gestão & Negócios
    • Institucionais
    • Inteligência Artificial
    • Mobile
    • UX & Design

    Leia também

    • Alura
      14/04/2020

      #QuarentenaDados: dê seus primeiros passos em Data Science

      Ler mais
    • 20/05/2021

      Conhecendo o JupyterLab

      Ler mais
    • 27/02/2025

      Transformando dados em insights: como criar um relatório baseado em análises de dados

      Ler mais
    Ver mais conteúdos

    Inscreva-se em nossa Newsletter

    Fique por dentro de conteúdos, insights e oportunidades do universo tech. Receba novidades e lançamentos direto no seu e-mail.

    Institucional

    • Sobre nós
    • Trabalhe Conosco
    • Para Empresas
    • Para Escolas
    • Política de Privacidade
    • Compromisso de Integridade
    • Termos de Uso
    • Canal de Ética
    • Código de Ética
    • Fale Conosco
    • Documentos Institucionais
    • Status
    Institucional
    • Sobre nós
    • Trabalhe Conosco
    • Para Empresas
    • Para Escolas
    • Política de Privacidade
    • Compromisso de Integridade
    • Termos de Uso
    • Canal de Ética
    • Código de Ética
    • Fale Conosco
    • Documentos Institucionais
    • Status

    A Alura

    • Como Funciona
    • Inteligência Artificial
    • Plataforma
    • Depoimentos
    • Instrutores(as)
    • Dev em <T>
    • Luri, a Inteligência Artificial da Alura
    • IA Conference
    • Cursos Imersivos
    • Perguntas Frequentes
    A Alura
    • Como Funciona
    • Inteligência Artificial
    • Plataforma
    • Depoimentos
    • Instrutores(as)
    • Dev em <T>
    • Luri, a Inteligência Artificial da Alura
    • IA Conference
    • Cursos Imersivos
    • Perguntas Frequentes

    Conteúdos

    • Alura Cases
    • Imersão Engenharia de Software: Dev na Era da IA
    • Artigos
    • Podcasts
    • Artigos de educação corporativa
    Conteúdos
    • Alura Cases
    • Imersão Engenharia de Software: Dev na Era da IA
    • Artigos
    • Podcasts
    • Artigos de educação corporativa
    Uma Empresa do GrupoLogo Grupo Alun

    Outras empresas do Grupo Alun

    • FIAP
    • STARTSE
    • PM3
    • LUMINA

    Ao submeter seu e-mail, você concorda com a política de privacidade da Alura.

    Redes Sociais & Apps

    instagram
    youtube
    tiktok
    x
    appStore
    googlePlay
    Alura