• Home

    Escolha seu Plano

    Carreiras Alura

    Evolua com profundidade técnica, direção clara e aplicação prática.

    Jornadas guiadas do básico ao avançado com checkpoints práticos, desenhadas para quem busca profundidade e protagonismo técnico.

    Iniciante

    Comece do zero com uma trilha clara e progressiva.

    Fundamentos práticos para dar os primeiros passos com segurança e construir uma base sólida.

    Intermediário

    Continue sua evolução com cursos que conectam fundamentos, ferramentas e prática profissional. Ganhe autonomia, e avance para projetos mais completos.

    Avançado

    Aprofunde temas técnicos e estratégicos para enfrentar desafios mais complexos. Explore boas práticas, arquitetura, performance com visão profissional.

    Cursos

    Ver mais cursos de Back-end
    • Pensamento computacional: fundamentos da computação e lógica de programação
    • Lógica de programação: mergulhe em programação com JavaScript
    • DDD: fundamentos do design orientado a domínio
    • ASP.NET: autenticação e autorização em APIs e aplicações web
    • Microsserviços: migração de monólitos e modularização

    Cursos

    Ver mais cursos de Dados
    • Python para Dados: primeiros passos
    • Excel: domine o editor de planilhas
    • Engenharia de Dados: Orquestração de Pipelines com Apache Airflow
    • Power BI Desktop: construindo meu primeiro dashboard
    • Governança e Arquitetura de Dados

    Cursos

    Ver mais cursos de Inteligência Artificial
    • IA: Explorando o Potencial da Inteligência Artificial Generativa
    • Engenharia de Prompt: Criando Prompts Eficazes para IA Generativa
    • Claude para Análise de Dados: prompts, integrações e automações
    • Agno: criando agentes e sistemas multiagente
    • Engenharia de software na era da IA: segurança de aplicações com agentes, MCPs e código gerado por IA

    Cursos

    Ver mais cursos de Front-end
    • HTML e CSS: ambiente, estrutura e estilo
    • React: realizando testes avançados com Jest e Testing Library
    • React: integrando TypeScript em projetos
    • JavaScript: aprendendo a programar
    • React: aplicando arquiteturas de Micro frontends

    Cursos

    Ver mais cursos de DevOps
    • Sistema Operacional Linux: fundamentos e administração prática
    • Containers e Docker: empacotamento, isolamento e gestão
    • Redes: dos conceitos iniciais à criação de uma intranet
    • Linux: gerenciando diretórios, arquivos, permissões e processos
    • Cibersegurança: Fundamentos e práticas integradas

    Cursos

    Ver mais cursos de UX & Design
    • UX Research: mapeando a experiência da pessoa usuária
    • UX/UI Design: Entregando produtos digitais com IA
    • UI Design: Prototipação e animações interativas
    • Figma: Conhecendo o programa
    • Product Design: métricas e ciclo de vida do produto

    Cursos

    Ver mais cursos de Gestão & Negócios
    • Canva: Criação de landing pages e e-mail marketing
    • Agilidade: como ela pode ajudar a criar um time de alta performance
    • Google Analytics 4: Extrair insights e configurar eventos
    • Management 3.0: gerencie o ambiente, não as pessoas
    • Automação de processos com n8n: Inteligência de dados para Marketing

    Cursos

    Ver mais cursos de Mobile
    • React Native: Estilização e Layouts com Flexbox e StyleSheet
    • Flutter: Graphql e suporte offline
    • Android com Gemini: Trabalhando com textos e imagens na IA
    • Dart: trabalhando com orientação a objetos
    • React Native: Dominando Listas com FlatList e ScrollView

    Carreiras

    Ver mais carreiras
    • Especialista em IA
    • Engenharia de IA
    • Ai native software engineering
    • Arquitetura de Soluções com IA
    • AI Product Design
    • Engenharia de Machine Learning
    • Desenvolvimento Front-End React
    • Engenharia de Dados
    • Cloud Security
    • Social Media Marketing
    • Engenharia de Agentes de IA

    Cursos

    • Engenharia de Prompt: Prompts Eficazes para IA Generativa
    • Claude Code: Criando sua Primeira Aplicação
    • Python: Crie sua Primeira Aplicação
    • Git e GitHub: Compartilhando e Colaborando
    • N8N: Fluxos de Trabalho Avançados

    Cursos

    • Copilot Studio: Solução Multiagentes
    • Padrões de API HTTP e Modelagem de APIs
    • Python para Análise de Dados com SQL
    • Docker: Criando e Gerenciando Containers
    • Design com IA: Otimizando o Processo Criativo

    Cursos

    • Model Context Protocol (MCP)
    • Spec-Driven Development: Dev Assistido por Agentes
    • Arquitetura de Sistemas Distribuídos com Java
    • Governança de Modelos e Reprodutibilidade
    • Pentest: Vulnerabilidades em Aplicações Web

    Escolha seu Plano

    Skills & Go

    O Skills & Go é para Tech Leads, Product Managers, estrategistas e early adopters que transformam ideias em soluções de alto impacto. Em cursos ao vivo e 100% online, você domina a nova era da IA em tempo real.

    Aulas ao vivo

    Saiba mais
    • Agentic Engineering: orquestre múltiplos agentes com confiabilidade
    • Building AI Products: transforme ideias em produtos reais com IA
    • AI Data Strategy: transforme dados em decisões estratégicas com IA

    Escolha seu Plano

    Eventos Alura

    Nossos eventos são pensados para quem quer estar à frente das mudanças em tecnologia, IA e inovação. Em experiências presenciais, você acompanha tendências e se conecta com especialistas que estão moldando o futuro.

    Próximos eventos

    • Imersão Engenharia de Software: Dev na Era da IA
    • IA Conference
    • Alura Signals
  • Talent Lab
  • IA

    Escolha seu Plano

    Conteúdos gratuitos

    Explore conteúdos gratuitos para aprender tecnologia no seu ritmo. Encontre artigos com conteúdos técnicos para aprender na prática, notícias para acompanhar as principais tendências do mercado e o Alura Labs, com análises e reflexões de especialistas sobre tecnologia, IA e carreira.

    Conteúdos gratuitos

    • Artigos
    • Notícias
    • Alura Labs
  • Para Empresas
Ver planos
Links principais
  • Planos e Promoções
  • Links complementares do menu mobile
  • Talent lab
  • Inteligência Artificial
  • Pós Graduações
  • Para Empresas
  • Sobre a Alura
  • Grupo Alun
  • Entrar
    • Home
    • Carreiras
    • Skills & Go
    • Talent Lab
    • Inteligência Artificial
    • Pós Graduações
    • Artigos
    • Sobre a Alura
    • Grupo Alun
    LoginContato
    • LinkedIn
    • Instagram
    • YouTube
    1. Página inicial
    2. Dados
    3. Machine Learning: o que é aprendizado semi-supervisionado

    Machine Learning: o que é aprendizado semi-supervisionado

    9 min9 minutos de leitura

    9 min9 minutos de leitura

    Publicado: 28/08/2023

    Última atualização: 09/03/2026

    1. O que é o aprendizado semi-supervisionado?
    2. Premissas para utilizar técnicas de aprendizado semi-supervisionado
    3. Algoritmos para aprendizado semi-supervisionado
    4. Conclusão
    5. Créditos

    Quando lidamos com um cenário onde a obtenção de dados e variáveis de interesse representam um processo custoso e demorado, precisamos buscar alternativas para aproveitar as informações disponíveis.

    O aprendizado semi-supervisionado surge como uma alternativa promissora às abordagens de aprendizado supervisionado e não supervisionado.

    Nesse artigo, vamos conhecer o aprendizado de máquina semi-supervisionado, explorando suas aplicações, vantagens e desafios, e desvendando como essa abordagem se diferencia das tradicionais abordagens supervisionadas e não supervisionadas, observando como ela pode ser uma ferramenta valiosa ao se enfrentar problemas com dados limitados.

    O que é o aprendizado semi-supervisionado?

    A ideia do conceito de supervisão em um modelo de aprendizado diz respeito a saber previamente informações sobre a variável target (alvo) do nosso conjunto de dados, que vai ser posteriormente explorado pelo modelo de aprendizagem.

    Por exemplo, se em um determinado grupo de pessoas desejamos saber uma característica específica sobre cada pessoa, como por exemplo, a nacionalidade, podem existir alguns cenários:

    1. Coletamos informações sobre a característica de nacionalidade de todas as pessoas do grupo e também temos acesso às outras informações, como: nome, endereço, comidas favoritas, e outros.
    2. Coletamos informações do grupo de pessoas, mas apenas parte dessa amostra possui informações sobre a nacionalidade.
    3. Não coletamos informações sobre a nacionalidade de cada pessoa, temos acesso apenas às outras informações de cada indivíduo.

    As situações acima remetem, respectivamente, às situações de aplicação de: aprendizado supervisionado, aprendizado semi-supervisionado e aprendizado não-supervisionado.
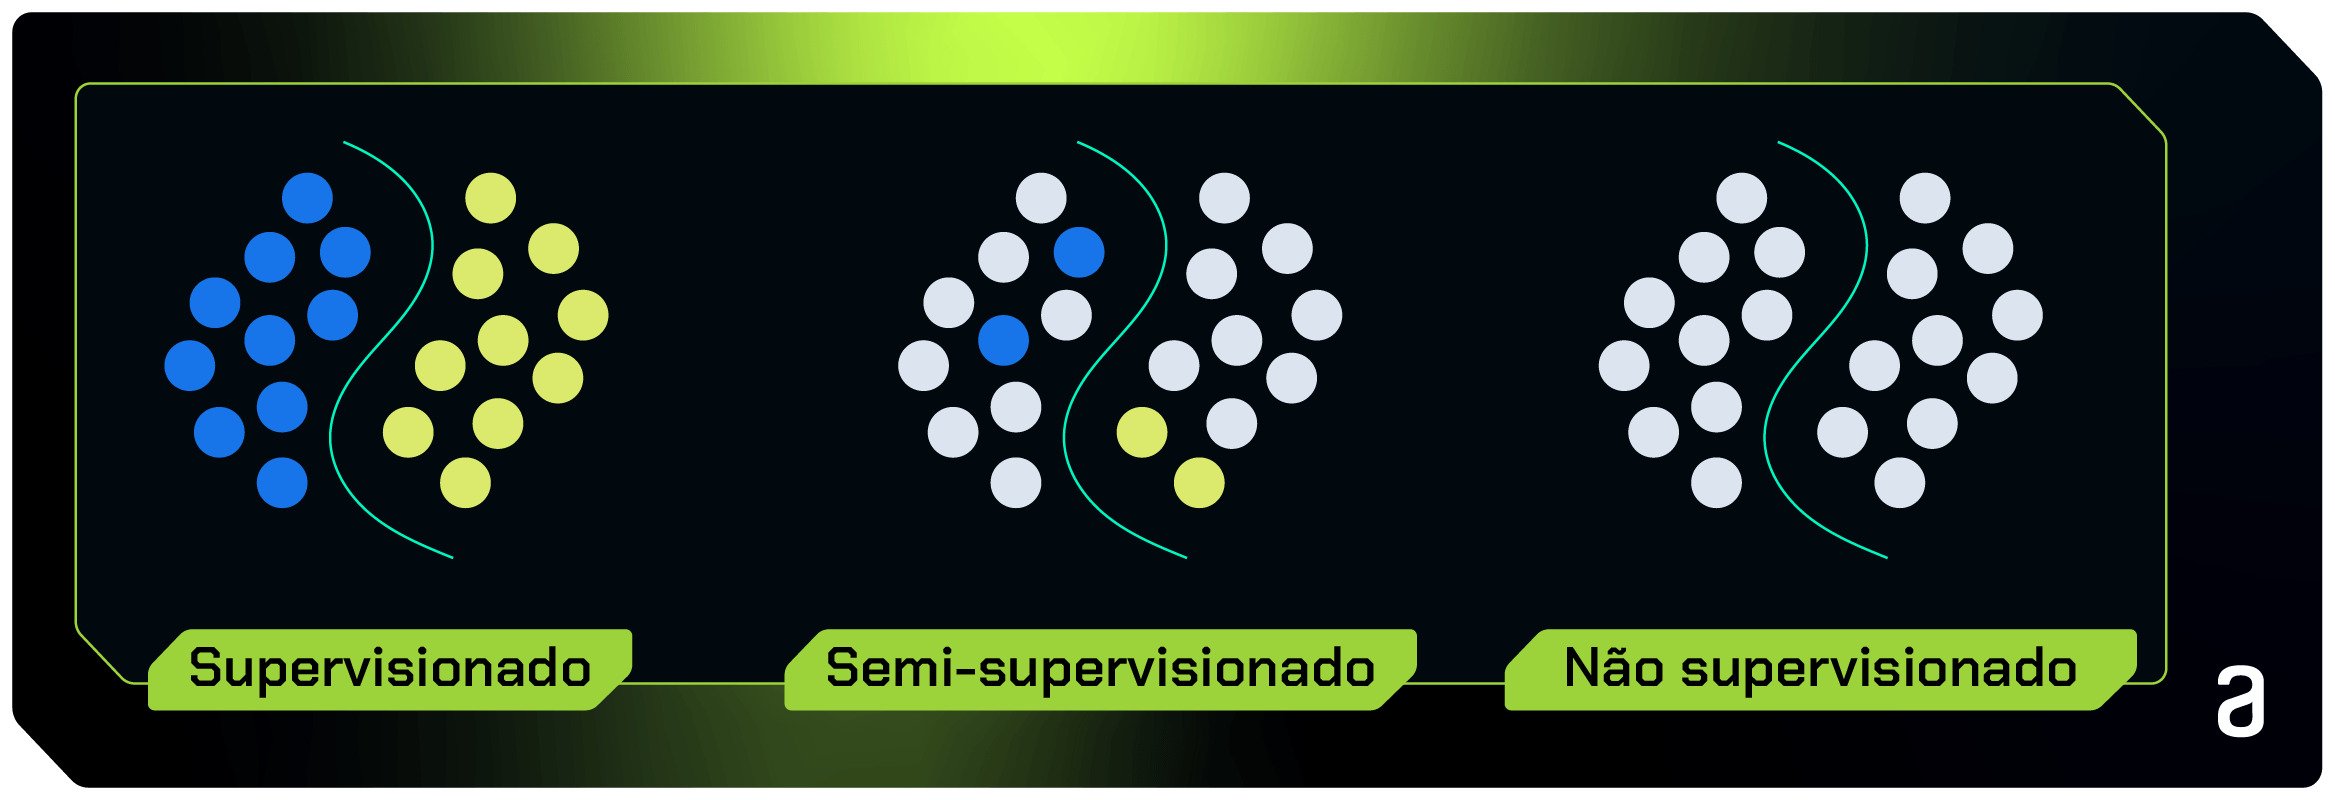
    Figura colorida. Na imagem, há três representações de tipos de aprendizado. O primeiro, da esquerda para a direita, tem o título “Supervisionado”, e na imagem, há uma linha divisória na cor verde, que separa dois grupos de pontos, do lado esquerdo, temos vários pontos azuis, e do lado direito, vários pontos amarelos. Ao centro, temos o título “Semi-supervisionado”, onde temos a mesma estrutura divisória anterior, mas somente 2 pontos coloridos em cada lado, e o restante na cor cinza. E a direita, a mesma estrutura divisória, mas com todos os pontos em ambos os lados coloridos em cinza.

    No caso particular do aprendizado semi-supervisionado, o objetivo é trabalhar em um cenário com problemas de rotulação parcial dos dados, onde as informações sobre a variável alvo são poucas.

    E a falta desses rótulos pode acontecer tanto por questões financeiras para coleta das informações, quanto também de custos operacionais que também dizem respeito a custo e esforço humano.

    Um exemplo simples de situação onde temos dados rotulados parcialmente pode ser observado na seguinte imagem:
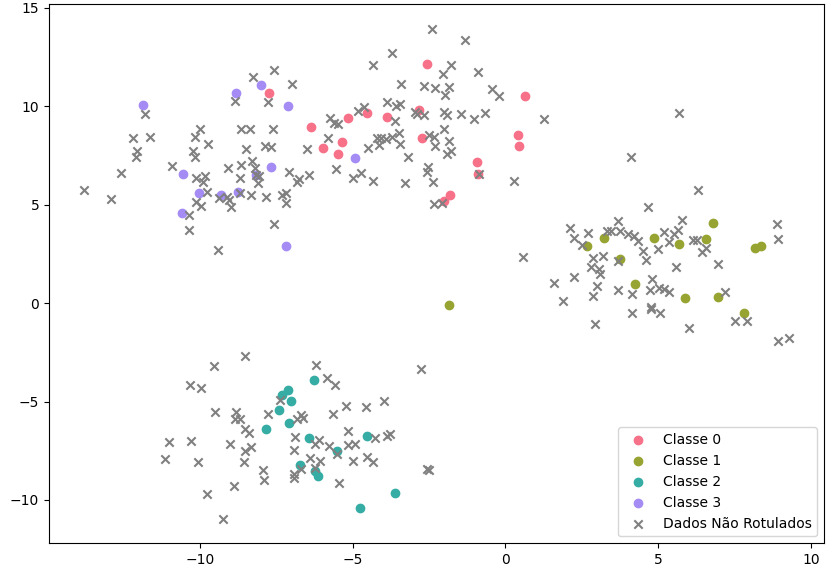
    Gráfico de dispersão. No gráfico, temos quatro nuvens de pontos. Em cada nuvem, há somente alguns pontos coloridos, com uma cor para cada grupo de pontos, e o restante dos pontos possui a forma de “x” na cor cinza. No canto inferior, há uma legenda com as relações. Pontos rosas são pertencentes a Classe 0. Pontos verdes são pertencentes a Classe 1. Pontos azuis são pertencentes a Classe 2. Pontos roxos são pertencentes a Classe 3. Pontos em X em cinza são “Dados Não Rotulados”.

    Neste exemplo, temos informações sobre os eixos X e Y para cada ponto, que seriam as suas características (features) no conjunto de dados, mas somente alguns registros possuem informações sobre a classe (o rótulo), que são representadas por quatro cores distintas.

    Os pontos não rotulados são representados pelos símbolos “x”, enquanto temos as outras quatro classes espalhadas em clusters (nuvens), onde os pontos semelhantes ficam próximos.

    Esse tipo de problema se repete em diversas situações em ciência de dados, inclusive para conjuntos com mais variáveis (maior dimensão).

    Contextualização do problema: detecção de fraudes em transações

    Imagine que você trabalha em uma instituição financeira e tem um grande conjunto de dados de transações de cartão de crédito. Seu objetivo é detectar atividades fraudulentas, onde transações fraudulentas são aquelas que não foram autorizadas pelo titular do cartão.

    Podemos ter um conjunto de transações rotuladas como "fraude" ou "não fraude". Nesse cenário, você poderia usar técnicas de aprendizado supervisionado, como Random Forest, para construir um modelo que aprenda apenas com as transações rotuladas.

    O modelo seria treinado usando as características das transações, como valor da transação, localização, horário do dia e etc. para prever se uma transação futura é uma fraude ou não.

    No entanto, a rotulação de fraudes é custosa e pode estar ausente na maioria dos dados. Em relação ao volume total de transações, a proporção de fraudes é bem menor, e o custo associado para verificar e investigar fraudes dificulta o processo para validar os rótulos.

    Agora, considere que você tem um grande número de transações não rotuladas. Para encontrar padrões e anomalias nessas transações não rotuladas, você pode aplicar técnicas de aprendizado não supervisionado, como algoritmos de agrupamento (por exemplo, K-Means).

    Isso pode ajudar a identificar grupos de transações que têm comportamento semelhante e destacar transações que parecem atípicas ou anômalas em relação aos grupos.

    E embora seja possível trabalhar descartando todos os rótulos e apenas usando as informações das transações, utilizar técnicas semi-supervisionadas favorecem alguns benefícios:

    1. Precisão aprimorada: A abordagem semi-supervisionada incorpora dados rotulados para melhor distinguir entre tipos de fraudes, tornando o modelo mais confiável e capaz de identificar nuances sutis.
    2. Redução de falsos positivos: Incorporar exemplos rotulados ajuda a minimizar os falsos positivos, melhorando a precisão das previsões de fraude.
    3. Aproveitamento de dados não rotulados: A abordagem semi-supervisionada maximiza o uso de dados não rotulados, útil quando rótulos de fraude são escassos ou caros de obter.
    4. Adaptação a mudanças: A abordagem semi-supervisionada permite ao modelo se adaptar a padrões de fraude em evolução, aproveitando tanto dados rotulados quanto não rotulados.
    5. Controle personalizado: Ajustar o uso de dados rotulados e não rotulados oferece maior controle sobre o treinamento do modelo, permitindo uma abordagem personalizada.

    Mas, para garantir que podemos utilizar o aprendizado semi-supervisionado com um bom aproveitamento, é necessário seguir alguns critérios.

    Banner do Guia Tático Alura sobre carreira em tecnologia, destacando o mapa da carreira tech. A imagem convida a explorar diferentes caminhos profissionais, comparar possibilidades e encontrar a próxima fase da carreira na área de tecnologia, com chamada “Explore o mapa”.

    Premissas para utilizar técnicas de aprendizado semi-supervisionado

    Existem algumas pressuposições gerais (premissas) que podem afetar a eficácia do aprendizado de máquina semi-supervisionado, e, para garantir a validez dos resultados, são interessantes de seguir.

    São elas: premissa de continuidade (suavidade), premissa de cluster, premissa de baixa densidade e premissa de variedade (manifold):
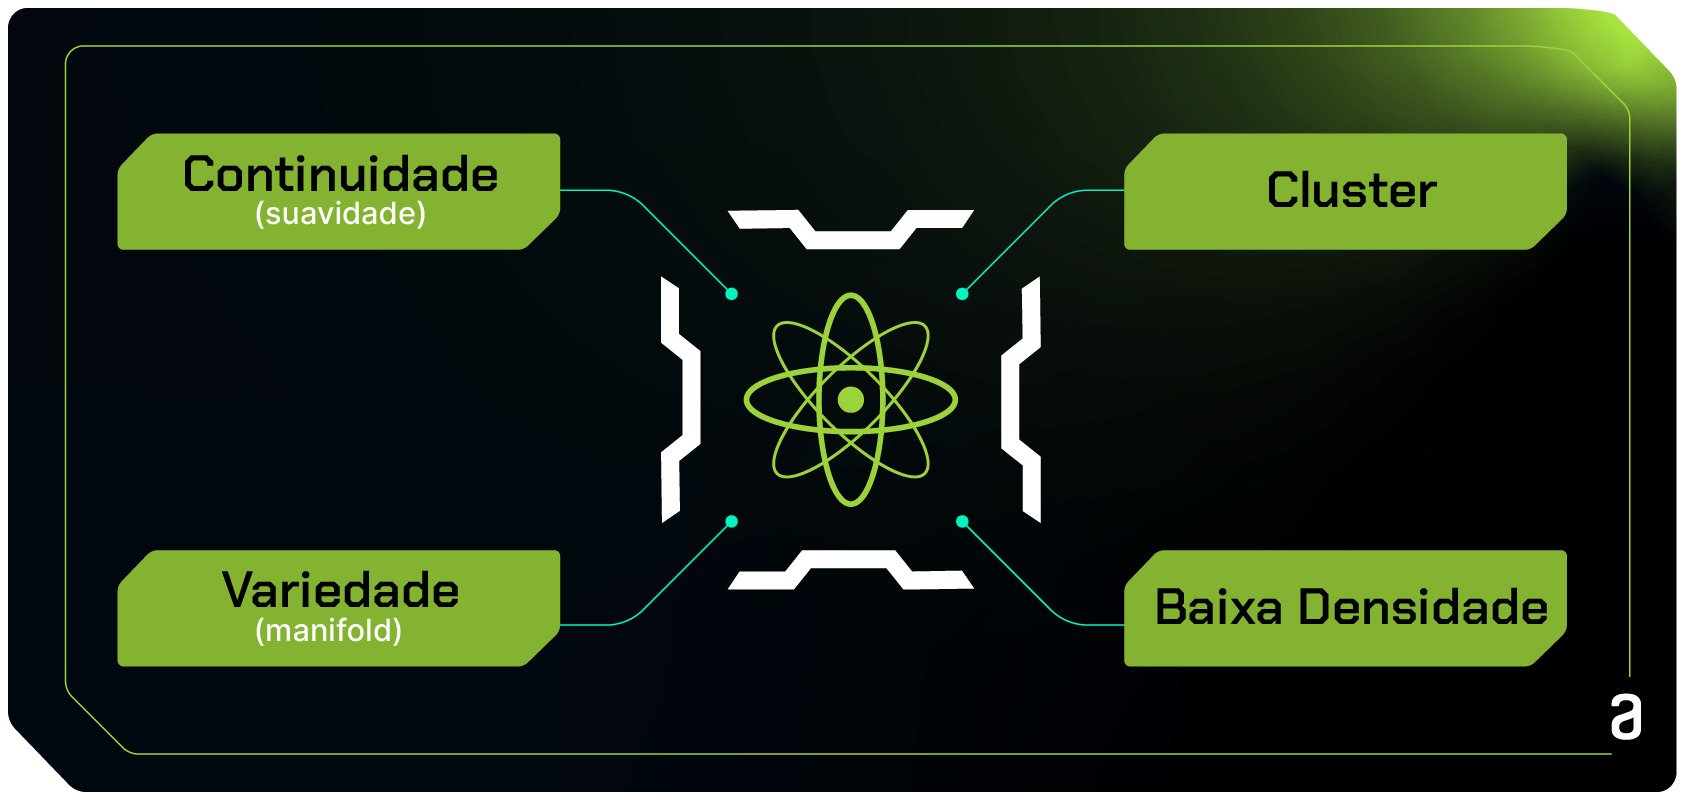
    Figura colorida. Na imagem, há quatro títulos dispostos conectados a um símbolo de Data Science ao centro da imagem. No canto esquerdo superior, o título “Continuidade (suavidade)”. No canto direito superior, o título “Cluster”. No canto esquerdo inferior, o título “Variedade (manifold)”. No canto direito inferior, o título “Baixa Densidade”.

    Premissa de continuidade (suavidade)

    Ela postula que dados próximos no espaço de características compartilham características semelhantes e tendem a pertencer à mesma classe. Em outras palavras, pontos de dados vizinhos têm maior probabilidade de possuir rótulos semelhantes.

    Essa premissa é frequentemente utilizada por algoritmos semi-supervisionados para estender os rótulos das amostras rotuladas para dados não rotulados próximos, melhorando a generalização do modelo.

    Premissa de cluster

    Ela postula que os dados possuem uma estrutura de agrupamento natural (cluster), ou seja, pontos de dados semelhantes tendem a formar grupos distintos.

    O aprendizado de máquina semi-supervisionado explora essa premissa ao usar dados rotulados para inferir a estrutura de agrupamento subjacente e, assim, atribuir rótulos a dados não rotulados próximos a um determinado grupo.

    Essa premissa é particularmente eficaz quando as amostras de uma mesma classe formam aglomerados bem definidos quanto às diferenças nas características do conjunto.

    Premissa de baixa densidade

    A premissa de baixa densidade parte do princípio de que as regiões de baixa densidade de dados contém informações valiosas. Em outras palavras, áreas com poucos dados rotulados podem representar desafios mais complexos de classificação ou regressão.

    Os algoritmos de aprendizado de máquina semi-supervisionado buscam aproveitar essas regiões, explorando os dados não rotulados para melhorar a capacidade de generalização em áreas menos densamente populadas, onde um modelo supervisionado poderia ter dificuldades pela falta de informação.

    Premissa de variedade (manifold)

    A premissa de variedade, também chamada de hipótese de manifold, sugere que os dados de alta dimensão muitas vezes residem em um espaço topológico de baixa dimensão (variedade).

    É uma análise matemática que considera problemas de machine learning onde os dados podem ser representados em um espaço euclidiano, e assume que os dados não rotulados próximos a dados rotulados provavelmente seguem a mesma estrutura subjacente da variedade.

    Algoritmos semi-supervisionados exploram essa premissa para prever rótulos em regiões pouco exploradas, melhorando a generalização do modelo em espaços de características complexas.

    Agora que conhecemos algumas das premissas necessárias para utilizar a técnica de aprendizado semi-supervisionado, vamos conhecer também alguns dos principais algoritmos.

    Algoritmos para aprendizado semi-supervisionado

    Existem diferentes tipos de técnicas para resolver o problema dos rótulos dos dados. E entre esses algoritmos, se destacam: Label propagation, Self-training, Co-training e SVM semi-supervisionada.

    Label Propagation

    O Label Propagation é um algoritmo clássico e amplamente utilizado para aprendizado semi-supervisionado. Ele aproveita a ideia de que dados semelhantes têm rótulos semelhantes.

    Figura colorida. Na imagem, há uma moldura com título “Label Propagation”. Dentro da moldura, no centro esquerdo há uma figura com grafos, onde há um círculo azul, que está ligado a 3 três círculos sem uma cor definida, com valor “?”, na sua vizinhança. E há um círculo amarelo, que possui 3 círculos sem cor definida, com valor “?”, na sua vizinhança. No lado direito, há um preenchimento nos círculos que tinham valor “?”, agora temos 4 círculos azuis conectados, e 4 círculos amarelos conectados. E no centro da imagem, há uma seta que aponta da esquerda para a direita.

    O algoritmo propaga os rótulos dos dados rotulados para os não rotulados com base nas similaridades entre eles.

    Um exemplo gráfico do comportamento dos dados de rótulos ao se utilizar algoritmos para prevê-los pode ser observado na imagem abaixo, onde é utilizado o Label Propagation:
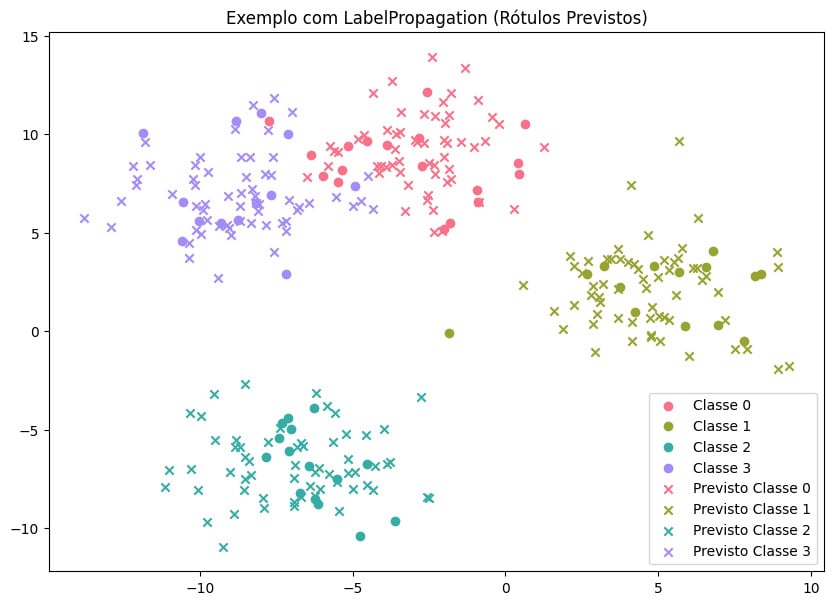
    Gráfico de dispersão. No gráfico, temos quatro nuvens de pontos. Em cada nuvem, todos os pontos são coloridos, com uma cor para cada grupo de pontos, e uma boa parte dos pontos possui a forma de “x” na cor respectiva de cada grupo. No canto inferior, há uma legenda com as relações. Pontos circulares e em formato “X”, na cor rosa, são pertencentes a Classe 0. Pontos circulares e em formato “X”, na cor verde, são pertencentes a Classe 1. Pontos  circulares e em formato “X”, na cor azul, são pertencentes a Classe 2. Pontos circulares e em formato “X”, na cor roxo, são pertencentes a Classe 3.

    Nessa imagem, pode-se observar que os pontos próximos aos clusters foram previstos como pertencentes a estes, e parece haver uma boa definição sobre o valor predito para cada registro.

    Na documentação do SKLearn, é possível encontrar informações sobre a implementação dessa técnica:

    • Label propagation - SKlearn

    Self-Training

    O algoritmo de self-training envolve treinar um modelo de aprendizado somente com os dados rotulados, e usá-los para rotular os dados não-rotulados com resultados mais assertivos (confiantes) e, em seguida, adicionar esses dados rotulados à base de treinamento. E esse processo é repetido em várias iterações. Esse método é relativamente simples e eficaz,

    Na documentação do SKLearn, é possível encontrar informações sobre a implementação dessa técnica:

    • Self-training Classifier - SKlearn

    Co-Training

    O co-training é uma abordagem derivada do self-training, que é especialmente útil quando há múltiplas fontes de dados ou características disponíveis, e a quantidade de rótulos disponíveis é pequena em relação ao tamanho do conjunto de dados analisados.

    O método envolve treinar modelos independentes em diferentes conjuntos de características e, em seguida, usar as previsões mais confiantes de cada modelo para treinar um outro modelo definitivo. A ideia fundamental por trás do co-training é que, quando duas ou mais fontes independentes de dados concordam em relação a um exemplo não rotulado, a confiança na rotulação desse exemplo aumenta, tornando-o mais confiável.

    Semi-Supervised SVM (Máquina de vetores de suporte Semi-Supervisionada):

    As SVMs semi-supervisionadas são uma extensão dos Support Vector Machine (SVMs) tradicionais para dados rotulados e não rotulados. Elas buscam encontrar um hiperplano que separe as classes rotuladas, levando em consideração os dados não rotulados.

    Na documentação do SKLearn, é possível encontrar informações sobre a implementação dessa técnica:

    • Support Vector Machine - SKLearn

    Conclusão

    E aí, curtiu? Nesse artigo, nós conhecemos alguns dos tipos de aprendizagem para machine learning e abordamos com mais detalhes o aprendizado semi-supervisionado, entendendo sobre as suas premissas de uso, algoritmos e algumas aplicações.

    Aqui na Alura nós temos vários conteúdos voltados a Machine Learning, Data Science e muito mais. Convidamos você a conhecer a Formação Machine Learning e também Formação Machine Learning Avançada, que conduzirão seu mergulho no universo de aprendizagem de máquina.

    Mergulhe em tecnologia! 🤿🌊


    Créditos

    • Conteúdo: Marcus Almeida
    • Produção técnica: Rodrigo Dias
    • Produção didática: Pedro Drago
    • Designer gráfico: Alysson Manso
    Banner do Guia Tático Alura sobre carreira em tecnologia, destacando o mapa da carreira tech. A imagem convida a explorar diferentes caminhos profissionais, comparar possibilidades e encontrar a próxima fase da carreira na área de tecnologia, com chamada “Explore o mapa”.

    Avalie este artigo

    • Foto de Marcus Almeida

      Autor(a)

      Marcus Almeida

      Bacharelando em Engenharia Elétrica pelo Instituto Federal do Maranhão. Atuou como parte do Scuba Team da Escola de Dados na Alura, trabalhando com conteúdos voltados a Data Science, Machine Learning, Python e SQL. Adora conversar tecnologia, universo geek, games e também aprender coisas novas.

    Explore por tópico

    • Back-end
    • Dados
    • DevOps
    • Front-end
    • Gestão & Negócios
    • Institucionais
    • Inteligência Artificial
    • Mobile
    • UX & Design

    Leia também

    • 18/11/2021

      Tableau: o que é, para que serve e como funciona

      Ler mais
    • 06/11/2019

      Polynote: O Jupyter notebook da Netflix

      Ler mais
    • 21/11/2022

      Power BI: tipos de licenças

      Ler mais
    Ver mais conteúdos

    Inscreva-se em nossa Newsletter

    Fique por dentro de conteúdos, insights e oportunidades do universo tech. Receba novidades e lançamentos direto no seu e-mail.

    Institucional

    • Sobre nós
    • Trabalhe Conosco
    • Para Empresas
    • Para Escolas
    • Política de Privacidade
    • Compromisso de Integridade
    • Termos de Uso
    • Canal de Ética
    • Código de Ética
    • Fale Conosco
    • Documentos Institucionais
    • Status
    Institucional
    • Sobre nós
    • Trabalhe Conosco
    • Para Empresas
    • Para Escolas
    • Política de Privacidade
    • Compromisso de Integridade
    • Termos de Uso
    • Canal de Ética
    • Código de Ética
    • Fale Conosco
    • Documentos Institucionais
    • Status

    A Alura

    • Como Funciona
    • Inteligência Artificial
    • Plataforma
    • Depoimentos
    • Instrutores(as)
    • Dev em <T>
    • Luri, a Inteligência Artificial da Alura
    • IA Conference
    • Cursos Imersivos
    • Perguntas Frequentes
    A Alura
    • Como Funciona
    • Inteligência Artificial
    • Plataforma
    • Depoimentos
    • Instrutores(as)
    • Dev em <T>
    • Luri, a Inteligência Artificial da Alura
    • IA Conference
    • Cursos Imersivos
    • Perguntas Frequentes

    Conteúdos

    • Alura Cases
    • Imersão Engenharia de Software: Dev na Era da IA
    • Artigos
    • Podcasts
    • Artigos de educação corporativa
    Conteúdos
    • Alura Cases
    • Imersão Engenharia de Software: Dev na Era da IA
    • Artigos
    • Podcasts
    • Artigos de educação corporativa
    Uma Empresa do GrupoLogo Grupo Alun

    Outras empresas do Grupo Alun

    • FIAP
    • STARTSE
    • PM3
    • LUMINA

    Ao submeter seu e-mail, você concorda com a política de privacidade da Alura.

    Redes Sociais & Apps

    instagram
    youtube
    tiktok
    x
    appStore
    googlePlay
    Uma Empresa do GrupoLogo Grupo Alun

    Outras empresas do Grupo Alun

    • FIAP
    • STARTSE
    • PM3
    • LUMINA

    Ao submeter seu e-mail, você concorda com a política de privacidade da Alura.

    Redes Sociais & Apps

    instagram
    youtube
    tiktok
    x
    appStore
    googlePlay
    Alura