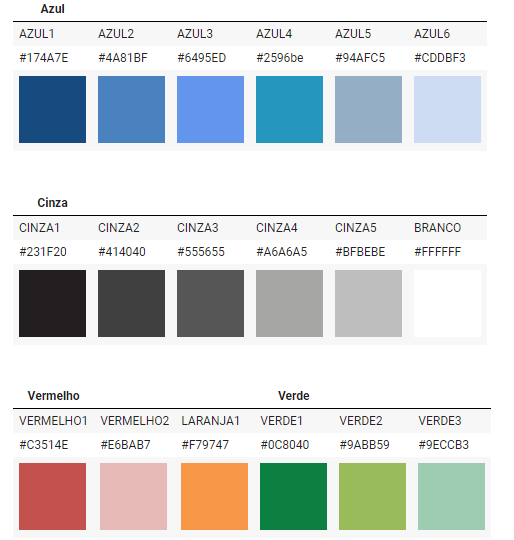
Já alinhamos a paleta de cores e importamos os dados que vamos utilizar em nosso projeto. Agora, para começar a construir os gráficos de composição, vamos trabalhar com os questionamentos propostos. Vamos começar pelo primeiro:
Como está disposto o PIB nos estados brasileiros no ano de 2020? É possível notar os estados com maior e menor participação no PIB nacional?
Nesse sentido, temos duas variáveis de interesse: o próprio estado, que seria a nossa "Sigla UF", e o valor do PIB.
Os valores a serem apresentados aqui serão em escala percentual, pois estamos trabalhando com valores expressivos, e talvez a escala percentual consiga tornar essa visualização mais compacta, permitindo-nos apresentar uma quantidade maior de dados no mesmo espaço.
Tratamento dos dados
Para isso, vamos primeiramente tratar nosso dado para fazer essa composição. Vamos criar um dataframe chamado df_pib_2020, e fazer uma cópia profunda do df_pib que importamos em nossa aula anterior, usando o método copy():
df_pib_2020 = df_pib.copy()
Fazemos uma cópia profunda para evitar que as alterações feitas em um dataframe afetem o outro. Logo, as alterações que faremos no df_pib_2020 não afetarão o df_pib.
Agora, vamos fazer um query (consulta) para obter apenas os dados do ano de 2020:
df_pib_2020 = df_pib_2020.query("ano == 2020")
Além disso, também vamos definir o valor do estado como nosso índice, usando set_index():
df_pib_2020 = df_pib_2020.query("ano == 2020").set_index("sigla_uf")
Estamos definindo o índice para facilitar quando formos trabalhar com gráficos, assim poderemos puxar esse valor mais facilmente para representar dentro da nossa visualização.
Também vamos ordenar esses valores (com o método sort_values()) de acordo com o PIB. A ordem será decrescente, do maior para o menor, então usamos o parâmetro ascending=False.
Por fim, selecionamos apenas a coluna "pib", ou seja, no nosso dataframe teremos o sigla_uf como índice e os valores de PIB como coluna, sendo apenas uma coluna, então:
df_pib_2020 = df_pib_2020.query("ano == 2020").set_index("sigla_uf").sort_values("pib", ascending=False)[["pib"]]
Depois, juntamos os dois códigos criados anteriormente com a consulta de df_pib_2020 usando o método head():
df_pib_2020 = df_pib.copy()
df_pib_2020 = df_pib_2020.query("ano == 2020").set_index("sigla_uf").sort_values("pib", ascending=False)[["pib"]]
df_pib_2020.head()
Rodando esse código, recebemos a visualização do nosso dataframe. Ele representa, no lado esquerdo, as siglas dos estados como índice e, no lado direito, os valores de PIB:
| sigla_uf | pib |
|---|
| SP | 2377638979835 |
| RJ | 753823710636 |
| MG | 682786116407 |
| PR | 487930593779 |
| RS | 470941846057 |
Mesmo esses sendo valores absolutos, ao representarmos no gráfico, veremos que os valores serão apresentados de forma relativa.
Desse modo, já conseguimos separar a quantidade que queremos no nosso código, que são apenas as duas variáveis de interesse: sigla_uf e pib.
Gerando o gráfico
Agora, vamos gerar o gráfico. Para isso, precisamos importar uma biblioteca que faça a criação desse gráfico, o Matplotlib:
import matplotlib.pyplot as plt
Vamos definir a área do gráfico, que é todo o espaço externo da visualização chamado de fig, e o eixo onde estará nosso gráfico, chamado de ax. A figura terá 6 de comprimento por 6 de largura:
fig, ax = plt.subplots(figsize=(6,6))
Abaixo, vamos gerar o nosso gráfico, que será um gráfico de pizza. Para isso, vamos utilizar a função ax.pie(). Ou seja, vamos passar ax, que será o nosso objeto axis (eixo) e, em seguida, .pie().
Esse ax.pie() recebe alguns parâmetros. Dentre eles, o data, que serão nossos dados; ou seja, o nosso df, que será o df_pib_2020.
Vamos passar também x, que será a nossa coluna "pib", ou seja, os valores. Também vamos passar os labels, que seriam os valores que estarão escritos próximos a essas fatias. Logo, labels será igual a df_pib_2020.index, porque as nossas siglas são os índices nesse nosso dataframe.
Além disso, vamos passar outros parâmetros. Temos o autopct, que se refere à representação da porcentagem dentro da pizza. Portanto, o autopct vai receber, entre aspas, uma string que vai formatar esse dado.
Para formatar, vamos começar e terminar com sinal de porcentagem, para mostrar que esse é o espaço de formatação, e escrever como será a formatação do dado. Logo, vamos colocar % seguido de um 1f e novamente porcentagem: autopct = "%.1f%".
Com isso, estamos indicando que queremos que o dado em percentual seja formatado com uma casa decimal. E, por fim, vamos colocar mais um sinal de porcentagem para que o símbolo apareça ao lado do número: "%.1f%%":
ax.pie(data = df_pib_2020, x = "pib", labels = df_pib_2020.index, autopct = "%.1f%%")
Outro parâmetro que podemos incluir nessa função seria o radius, o raio da pizza. Portanto, vamos colocar um radius de 1.1. O pctdistance é a distância do centro da pizza até o ponto onde queremos que seja escrito nosso dado. Assim, vamos definir como 0.8, para colocar mais próximo do final da pizza, e não próximo do centro.
Por fim, vamos trazer um outro componente, que serão as propriedades do texto.
Vamos chamar um textprops que vai receber um dicionário (("")) . Nesse dicionário, vamos passar apenas a modificação do size, o tamanho, definindo-o como 12.
Dessa forma, teremos o seguinte código para gerar o gráfico:
ax.pie(data = df_pib_2020, x = "pib", labels = df_pib_2020.index, autopct = "%.1f%%",
radius = 1.1, pctdistance=0.8, textprops={"size":12})
Além disso, vamos também personalizar essa visualização e criar um título superior, "Produto Interno Bruto (PIB) por estado (2020)" explicando os valores percentuais no subtítulo:
plt.suptitle('Produto Interno Bruto (PIB) por estado (2020)', size=18, color=CINZA1)
plt.title('Em porcentagem (%)', fontsize=14, color=CINZA3, pad = 15, x = 0.1, y = 0.98 )
Vamos executar o código para ver como ficou o nosso gráfico:
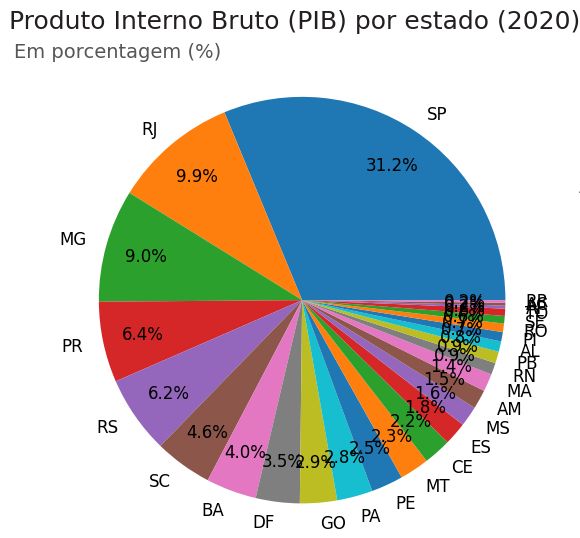
Fica um pouco difícil de visualizar, não é? São Paulo, Rio de Janeiro e Minas Gerais, com a maior representatividade, são mais fáceis de distinguir dos outros estados. Quanto menor for a participação do estado no PIB, mais difícil enxergar. Não conseguimos notar os estados menores.
Para resolver esse problema, vamos executar um código de texto na célula de criação do gráfico, que vai trazer uma pequena explicação sobre seu comportamento:
ax.text(1.1, 0.5,
'Um $\\bf{gráfico\ de\ pizza}$, consegue trazer a informação de\n'
'participação no PIB de forma direta, no entanto, percebemos\n'
'que o uso de $\\bf{muitas\ fatias}$ atrapalham na análise dos\n'
'dados para estados com $\\bf{menor}$ parcela no PIB.\n'
'Além de gerar incômodo visualmente para quem lê.\n\n'
'Percebemos que os estados de $\\bf{São\ Paulo}$, $\\bf{Rio\ de\ Janeiro}$ e $\\bf{Minas\ Gerais}$\n'
'possuem $\\bf{maior}$ participação no PIB nacional, porém, não conseguimos\n'
'precisar quais estados tem a menor e quanto seria em percentual.',
fontsize=12,
linespacing=1.45,
color=CINZA3, transform= ax.transAxes)
plt.show()
Ela explica, basicamente, que o nosso gráfico consegue trazer de maneira direta a participação de cada um dos estados brasileiros no PIB de 2020; no entanto, o uso de muitas fatias prejudica a nossa visualização. Além de gerar um pouco de desconforto ao olhar esse tipo de gráfico, quanto menor o valor, mais difícil será perceber qual é a participação dos estados:
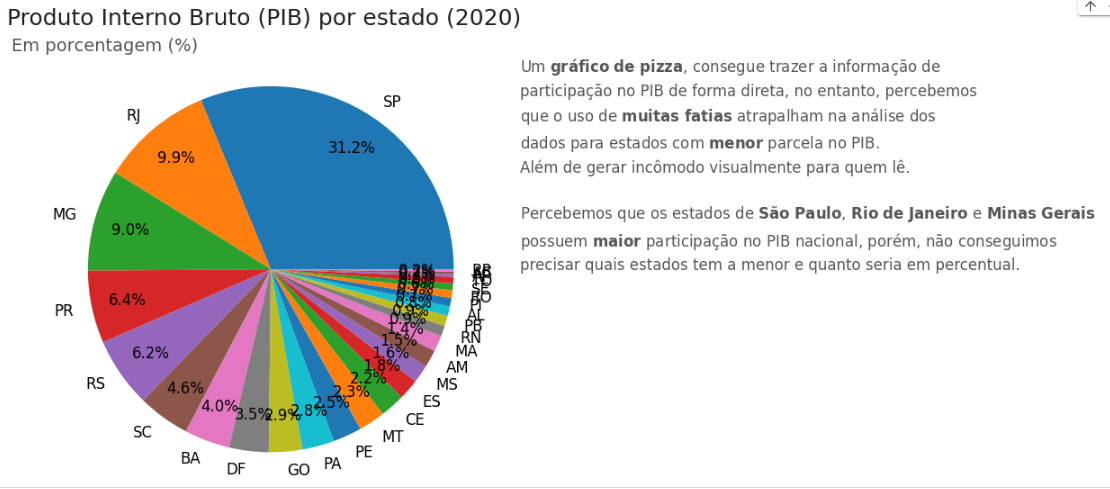
Portanto, um gráfico de pizza não é adequado para muitas fatias, ou seja, para muitas categorias de dados.
Nesse ponto, podemos pensar no seguinte: se o gráfico de pizza não é ideal para uma quantidade tão grande de fatias, qual o máximo de fatias que podemos representar? Precisamos refletir sobre isso.
Conseguiremos utilizar a pizza de alguma forma para representar nossos dados? Descobriremos a seguir!