Classificando textos com Python
9 minutos de leitura

Vamos ensinar o nosso programa quais comentários são permitidos e quais não são. Isto é, podemos dar para ele um monte de comentários dizendo quais são ofensivos ou não. Com isso, quando um novo comentário aparecer, ele saberá como classificá-lo.
Ensinando a máquina
Eu já tenho aqui no meu computador um arquivo CSV com vários comentários já classificados para ensinarmos nosso algoritmo. Já que vamos utilizar esse arquivo, precisamos abri-lo.
Uma maneira de abrirmos esse arquivo é utilizar a biblioteca Pandas. Essa é uma biblioteca muito utilizada por pessoas que fazem análise de dados ou aprendizado de máquinas, pois ela fornece uma série de funções e classes que nos ajuda a manipular os dados.
Podemos instalar essa biblioteca com o comando pip:
> pip install pandas
Já temos o Pandas instalado no nosso computador. Vamos falar para o Python começar a usá-lo no nosso código. Logo, falamos para o Python importá-lo (import). Pelo fato do Pandas ser uma biblioteca muito utilizada, é quase que uma convenção importá-lo como (as) pd.
import pandas as pd
Vamos falar para o Pandas ler o nosso arquivo de comentários (pd.read_csv()) e atribuí-los a uma variável:
import pandas as pd
comentarios = pd.read_csv('comentarios.csv')
Nesse arquivo CSV, temos os comentários e suas classificações. Para ensinar nosso algoritmo, precisamos passar esses dados separadamente, isto é, precisamos dizer para ele quais são os comentários e quais são suas classificações. Já que vamos precisar desses valores, vamos atribuir cada um em uma variável:
import pandas as pd
comentarios = pd.read_csv('comentarios.csv')
textos = comentarios['comentarios']
classificacao = comentarios['classificacao']
Quando formos ensinar nosso algoritmo ele pegará cada texto e classificação e aprenderá se aquele comentário é ofensivo ou não… Cada texto? O que torna um comentário ofensivo é o comentário em si, isto é, o texto puro, ou as palavras contidas nele?
Cada palavra em um comentário tem um peso, ou seja, não podemos olhar um comentário como um todo, mas cada palavra que compõem este comentário. Logo, vamos falar para o Python pegar essa nossa string (str) de comentários e separá-la (slipt()):
import pandas as pd
comentarios = pd.read_csv('comentarios.csv')
textos = comentarios['comentarios']
classificacao = comentarios['classificacao']
textos_quebrados = textos.str.split()
Para ensinar nosso algoritmo, precisamos contar quantas vezes cada palavra apareceu em um comentário. Isto é, do nosso conjunto de palavras, temos que contar quantas vezes cada palavra aparece. Mas já temos esse conjunto de palavras?
O que temos até então são os textos dos comentários quebrados em palavras. Nós podemos falar para o Python criar um conjunto (set) de palavras e para cada palavra nos textos_quebrados, atualizar esse conjunto:
import pandas as pd
comentarios = pd.read_csv('comentarios.csv')
textos = comentarios['comentarios']
classificacao = comentarios['classificacao']
textos_quebrados = textos.str.split()
palavras = set()
for palavra in textos_quebrados:
    palavras.update(palavra)
Um conjunto, ou um set, é uma estrutura de dados que guarda apenas uma ocorrência de cada objeto, que no nosso caso é uma palavra. Ou seja, se tivermos dez comentários com a palavra legal, no nosso conjunto, essa palavra aparecerá somente uma vez.
Mas se nossa palavra só aparece uma vez em nosso conjunto, como vamos saber quantas vezes ela apareceu?
Temos que contar quantas vezes cada palavra apareceu no texto, nós podemos criar uma função para isso. Nossa função criará uma lista com o número de vezes que cada palavra apareceu no comentário.
Para contar as palavras, precisamos saber qual é a palavra. Ou seja, podemos usar a posição da nossa palavra no conjunto:
# restante do código
print(palavras[0])
Quando executamos esse código, recebemos um erro:
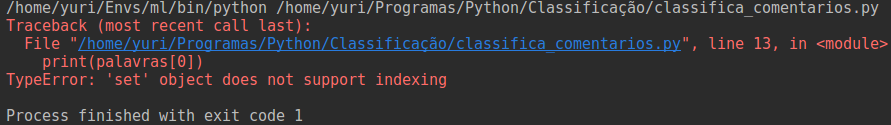
Ele nos diz que o objeto set, não suporta indexação. Ou seja, não conseguimos acessar um conjunto por um índice, como fazemos com as listas. Isso acontece porque os conjuntos têm um modo um pouco diferente de armazenar os elementos.
Os conjuntos utilizam uma estrutura chamada tabela de dispersão para armazenar seus dados.
Quando adicionamos um novo elemento, o conjunto usa desse algoritmo para colocar nosso dado em uma posição. Por isso, não podemos acessar os dados de um conjunto pelo seu índice, pois não sabemos em qual posição esse elemento se encontra.
Então como vamos contar as palavras se não temos um índice?

Criando um tradutor
Nós podemos criar um índice para as nossas palavras, ou seja, para cada palavra em nosso conjunto, podemos atribuir um número. Por exemplo, podemos falar que a palavra Gostei tem o índice 1, ficando: ('Gostei', 1). Mas teremos que fazer isso para cada palavra?
Nós podemos criar uma função que se encarrega dessa tarefa, porém, o Python nos fornece muitas funções, inclusive uma que faz exatamente isso que estamos querendo.
Queremos criar um índice para as nossas palavras, uma maneira de fazer isso é utilizando a função range. Com ela, conseguimos criar uma sequência de números, por exemplo, podemos falar para a range criar um série de números baseada no tamanho (len) do nosso conjunto de palavras:
# restante do código
indices = range(len(palavras))
Se nós imprimirmos essa variável, teremos o seguinte resultado:

Ela nos devolve uma função range que vai de 0 até 383 exclusive. Nós podemos utilizar isso e atribuir a cada palavra um número. Isto é, nós empacotamos (zip) cada palavra com um número:
# restante do código
indices = range(len(palavras))
zip(palavras, indices)
Com nossas palavras agrupadas com um número, nós podemos criar um tradutor, isto é, um dicionário para cada (for) palavra, indice em nosso agrupamento (zip(palavras, indices)):
# restante do código
indices = range(len(palavras))
tradutor = {palavra: indice for palavra, indice in zip(palavras, indices)}
Bacana! Agora cada palavra de nosso tradutor tem um índice, podemos finalmente começar a escrever nossa função para contar as palavras.
Vetorizando um texto
Nossa função terá que pegar todas as palavras do nosso tradutor e nos devolver uma lista com a contagem de cada palavra naquele comentário. Para isso ela deve receber um texto, ou seja, o comentário, e o nosso tradutor:
# restante do código
def vetorizar_textos(texto, tradutor):
Nossa função precisa contar cada palavra que aparece no comentário, para isso, podemos criar uma lista que tem o tamanho do nosso tradutor:
# restante do código
def vetorizar_textos(texto, tradutor):
    vetor_de_palavras = [0] * len(tradutor)
E, para cada palavra, checar se ela está no nosso tradutor, se sim, pegamos a posição desta palavra e incrementamos o valor naquela posição do nosso vetor:
# restante do código
def vetorizar_textos(texto, tradutor):
    vetor_de_palavras = [0] * len(tradutor)
    for palavra in texto:
        if palavra in tradutor:
            posicao = tradutor[palavra]
            vetor_de_palavras[posicao] += 1
    return vetor_de_palavras
Já temos a função para vetorizar nossos textos. Agora podemos falar no nosso script principal para vetorizar cada comentário, em nossos comentarios_quebrados utilizando nosso tradutor:
# restante do codigo
comentarios = pd.read_csv('comentarios.csv')
textos = comentarios['comentarios']
classificacao = comentarios['classificacao']
textos_quebrados = textos.str.split()
palavras = set()
for palavra in textos_quebrados:
    palavras.update(palavra)
indices = range(len(palavras))
print(indices)
tradutor = {palavra: indice for palavra, indice in zip(palavras, indices)}
vetores_de_texto = [vetorizar_textos(texto, tradutor) for texto in textos_quebrados]
Vetorizamos nosso texto, agora precisamos ensinar os algoritmos.
Criando nossos modelos
Já temos nossos textos vetorizados, agora temos que treinar nosso algoritmo. Existem vários algoritmos que podemos utilizar. Um algoritmo muito utilizado quando queremos classificar algo é o Teorema de Bayes. Podemos utilizar o módulo naive_bayes da biblioteca scikit-learn.
# restante do codigo
from sklearn.naive_bayes import MultinomialNB
modelo = MultinomialNB()
A classe MultinomialNB é uma implementação do algoritmo de Bayes. Nós podemos usar ela para treinar (fit) nosso modelo:
# restante do codigo
from sklearn.naive_bayes import MultinomialNB
modelo = MultinomialNB()
modelo.fit(vetores_de_texto, classificacao)
Legal, nosso modelo está treinado, agora já podemos falar para ele predizer (predict) um comentário, basta separar cada palavra do texto e vetorizá-lo.
# restante do codigo
from sklearn.naive_bayes import MultinomialNB
modelo = MultinomialNB()
modelo.fit(vetores_de_texto, classificacao)
modelo.predict(comentario_vetorizado)
O método predict nos devolve um array do Numpy com a nossa classificação.
Para saber mais
Classificar comentários é apenas uma tarefa que conseguimos realizar com aprendizagem de máquina. Com um código parecido com o que realizamos, podemos classificar se uma mensagem é spam ou não. Podemos verificar se o texto se trata de um assunto financeiro ou não, entre várias outras possibilidades.
Esse nosso algoritmo já funciona muito bem, porém podemos melhorá-lo. Se dermos uma olhada no nosso conjunto de palavras veremos algo como:
{‘bom’, ‘Bom’, ‘carros’, ‘carro’, ...}
Bom é bom são as mesmas palavras. A diferença é que uma está em caixa alta e a outra não. Pelo fato do Python ser uma linguagem case-sensitive, ela diferencia letras maiúsculas de minúsculas e isso pode afetar o modo que nosso algoritmo classifica os dados.
Para resolver isso, podemos converter todas as letras para minúsculo no momento que estamos quebrando os textos, por exemplo:
import pandas as pd
comentarios = pd.read_csv('comentarios.csv')
textos = comentarios['comentarios']
classificacao = comentarios['classificacao']
textos_quebrados = textos.str.lower().str.split()
palavras = set()
for palavra in textos_quebrados:
    palavras.update(palavra)
# restante do codigo
Se olharmos nosso conjunto de palavras agora, veremos que nosso conjunto só contém uma palavra bom:
{‘bom’, ‘carros’, ‘carro’, ...}
Mas ainda temos algumas palavras no plural, como será que podemos resolver isso?
Nós podemos ir de palavra em palavra checando se ela é plural ou não, porém isso é um pouco trabalhoso. Uma outra maneira é utilizar uma biblioteca para transformar nossas palavras em uma só, isto é, extrair a raiz da palavra.
Uma biblioteca muito utilizada para isso é a NLTK. Essa biblioteca nos permite manipular textos de várias formas. Podemos extrair a raiz das palavras, retirar pontuações e até mesmo verificar e excluir termos comuns, como artigos e preposições.
Ou seja, podemos melhorar muito nosso algoritmo retirando "sujeiras" que podem atrapalhar nosso modelo na parte de aprendizagem e predição.
Aqui na Alura, temos uma formação em Data Science. Nela você aprenderá como funciona algum dos algoritmos de classificação, como utilizar a biblioteca NLTK e muiot mais.
Avalie este artigo

Autor(a)
Yuri Matheus
Yuri é desenvolvedor e instrutor. É estudante de Sistemas de Informação na FIAP e formado como Técnico em Informática no Senac SP. O seu foco é nas plataformas Java e Python e em outras áreas como Arquitetura de Software e Machine Learning. Yuri também atua como editor de conteúdo no blog da Alura, onde escreve, principalmente, sobre Redes, Docker, Linux, Java e Python.


Inscreva-se em nossa Newsletter
Fique por dentro de conteúdos, insights e oportunidades do universo tech. Receba novidades e lançamentos direto no seu e-mail.