00HORAS
00MIN
00SEG
Compre com desconto

Primeiras aulas do curso

Regressão Linear: técnicas avançadas de modelagem

Análises preliminares - Introdução

Olá! Sou Rodrigo e dou as boas vindas ao curso de Regressão Linear: Técnicas Avançadas de Modelagem da Alura, que será como uma continuação do curso de Regressão Linear: Testando Relações e Prevendo Resultados.

Trabalharemos algumas técnicas diferentes para lidar com problemas cotidianos para pessoas que trabalham com data science, mantendo o padrão utilizado no curso anterior, ou seja, criaremos um notebook, que ficará todo documentado, com as células vazias, e as preencheremos ao longo dos estudos.

Estudaremos técnicas de transformação de variáveis, inclusive de algumas que não apresentam relação linear entre si. E, a partir dessas técnicas de transformação, conseguiremos resolver problemas e estimar modelos de Regressão Linear.

Além disso, nesse notebook, conheceremos testes mais formais de parâmetros de regressão. Anteriormente, abordamos análises gráficas e testes informais. Agora, lidaremos com os testes mais formais, sem entrar em muitos detalhes em testes de hipótese. Basicamente, entenderemos a forma de interpretar os testes, chegando à conclusões.

Será um curso bem prático, para que possamos utilizar o conteúdo no dia a dia, de fato. Espero que seja bastante útil no seu trabalho e ajude seus estudos.

Adiante, já colocaremos a mão na massa e conheceremos o data set. Vamos lá?

Análises preliminares - Conhecendo o dataset

Começaremos conhecendo o ambiente que foi criado para desenvolvimento desse segundo curso de Regressão Linear. O arquivo que o contém está disponível para download em "Projeto inicial do treinamento", no menu à esquerda.

Feito o download do projeto, acessaremos "data-science > reg-linear-II". Nessa pasta, encontraremos os conjuntos de dados que serão utilizados.
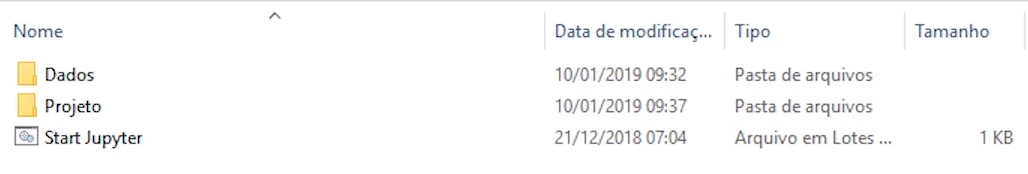
Duas pastas: "Dados" e "Projeto" e o arquivo `Start Jupyter.bat`

Dentro de "Dados", temos o arquivo dataset.csv e uma pasta ("img") com as imagens que serão exibidas no notebook. Já em "Projeto", encontramos a pasta ".ipynb_checkpoints" e o arquivo Regressão Linear.ipynb, o notebook que utilizaremos. Por fim, o arquivo Start Jupyter.bat, no qual escrevemos jupyter notebook para iniciar o Jupyter, dentro dessa pasta que estamos trabalhando. Ou seja, essa pasta funcionará em qualquer local que for salva — isso se as variáveis de ambiente estiverem configuradas corretamente.

Clicaremos duas vezes em Start Jupyter.bat para abrir a nossa pasta.
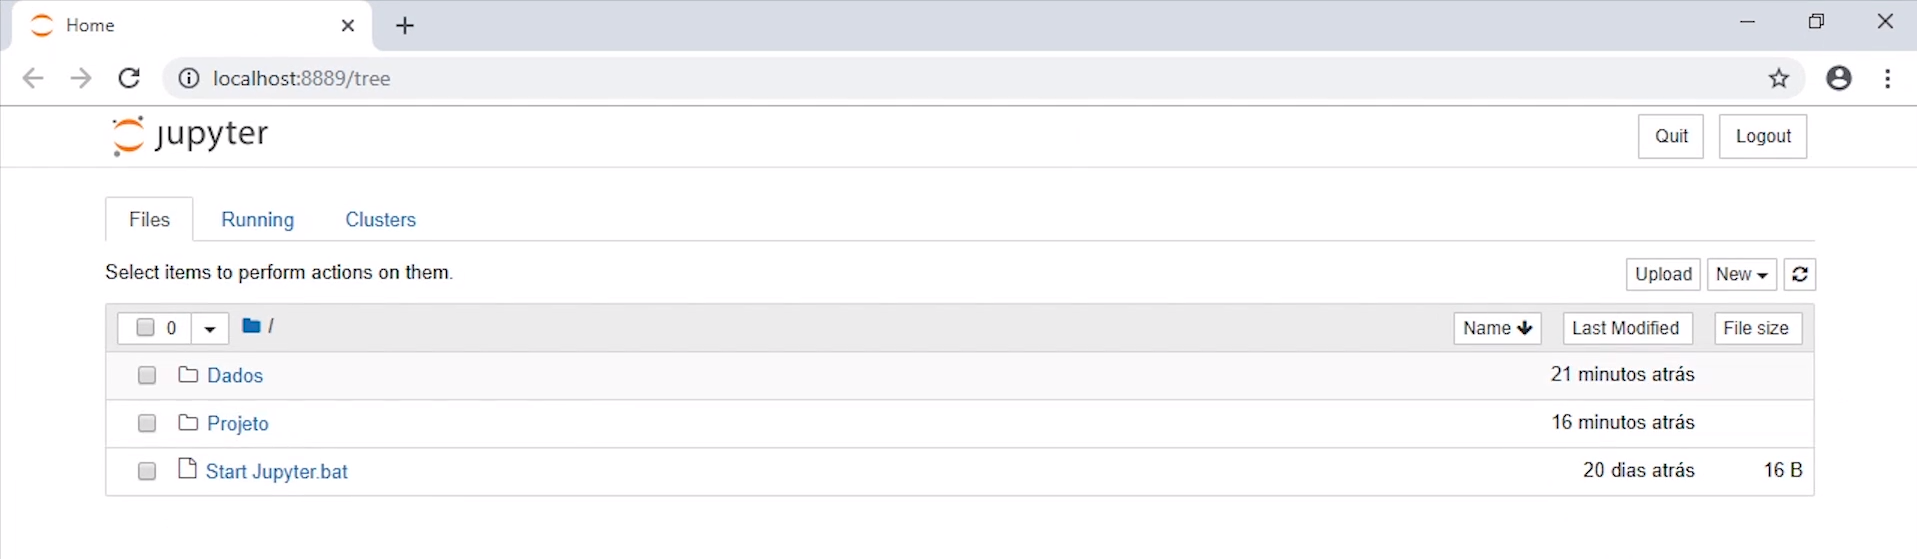
Assim que ela abrir, acessaremos "Projeto > Regressão Linear.ipynb". Uma nova aba se abrirá com o nosso notebook, Regressão Linear.ipynb.
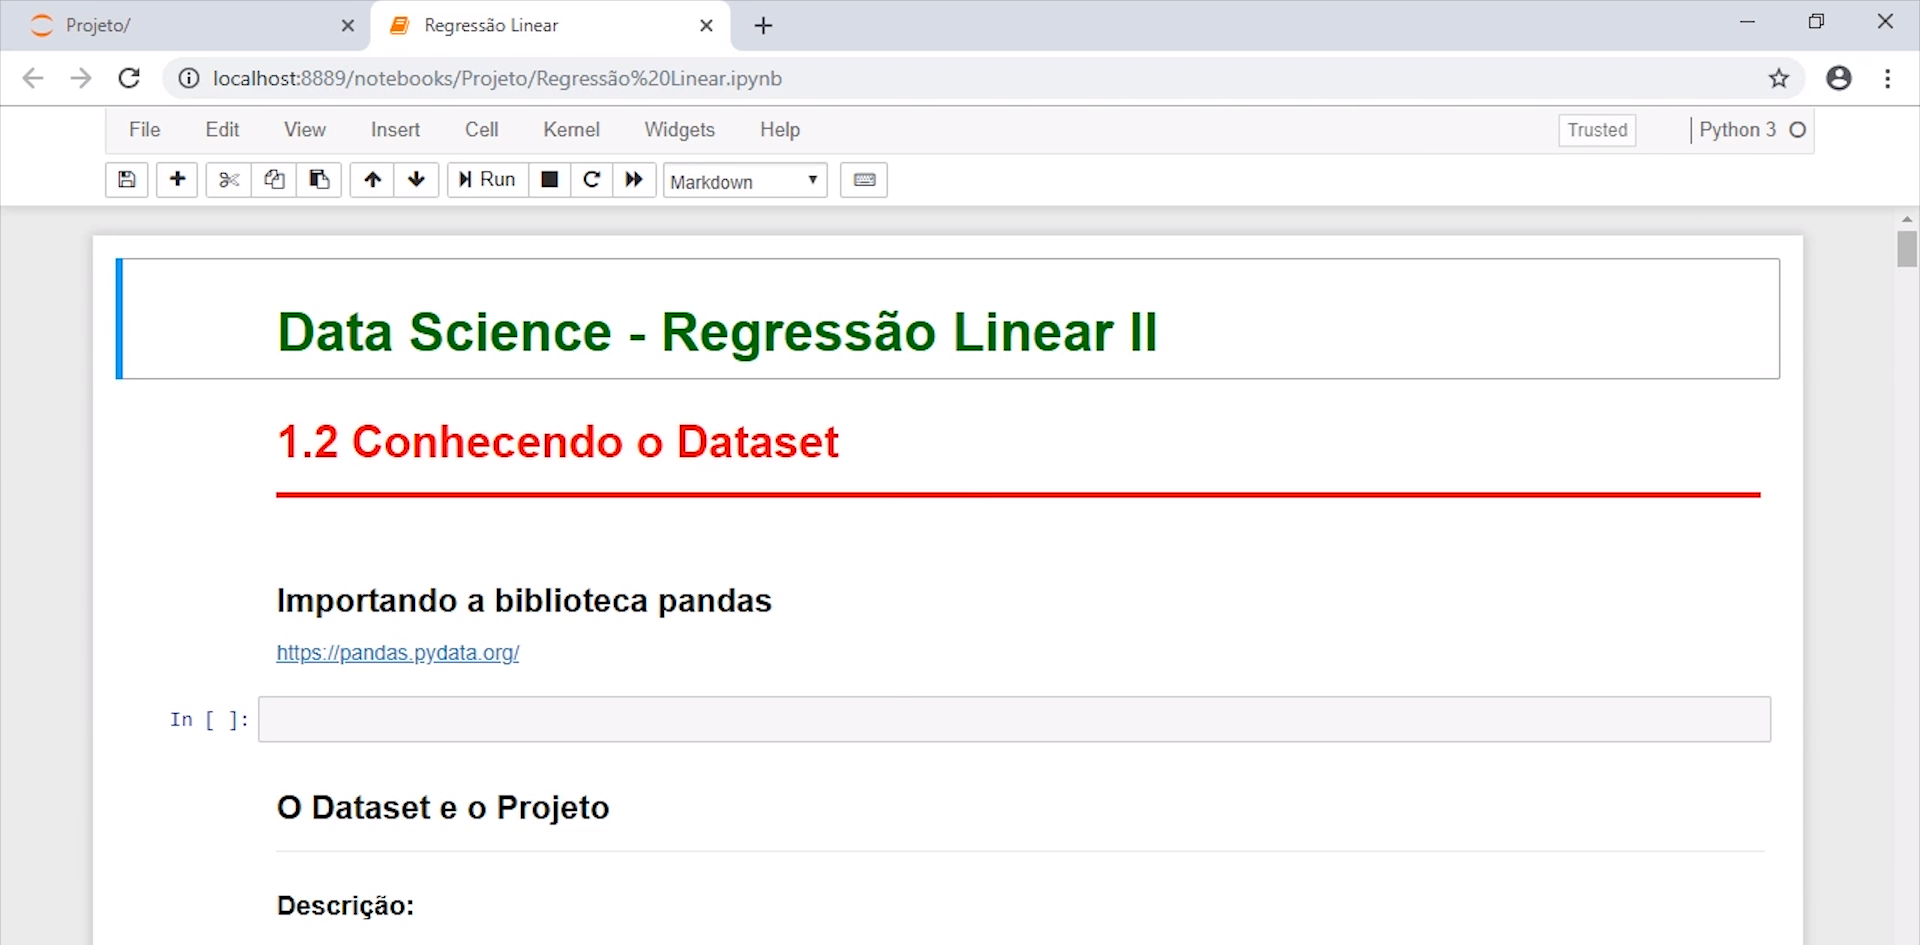
Da mesma forma que no curso anterior, o notebook já está preparado, para servir como um roteiro tanto para esse curso, quanto para executar seus projetos individuais. Se analisarmos, perceberemos que ele já está todo documentado. As células estão vazias, mas serão preenchidas ao longo de nossos estudos.

Inicialmente, conheceremos o Dataset que será utilizado no projeto. Logo no início do notebook, no item "1.2 Conhecendo o Dataset", encontramos "Importando a biblioteca pandas", seguido pelo seguinte link: https://pandas.pydata.org. Abaixo, na célula vazia, faremos a importação, digitando:

import pandas as pd

E teclaremos "Enter". Feita a importação, abaixo, encontraremos um Dataset sobre o mercado imobiliário, semelhante ao que foi utilizado no curso de Pandas, para executar o nosso projeto.

Para esse curso, foram feitas algumas adaptações para destacar alguns assuntos de Regressão Linear. No caso, encontraremos nos "Dados" de "Dataset" as seguintes variáveis:

  • Valor — Valor (R$) de oferta do imóvel
  • Area — Área do imóvel em m²
  • Dist_Praia — Distância do imóvel até a praia (km) (em linha reta), no caso a orla mais próxima
  • Dist_Farmacia — Distância do imóvel até a farmácia mais próxima (km) (em linha reta)

Dica: Caso tenha curiosidade em saber como criar as duas últimas variáveis, recomendo esses dois cursos de GeoPandas da Alura:

Na célula vazia de "Leitura dos dados", vamos abrir a pasta "Dados" para fazer a leitura de dataset.csv, digitando:

dados = pd.read_csv('../Dados/dataset.csv', sep=';')

Assim, nomeamos como dados, chamamos o Pandas com pd e solicitamos a leitura do arquivo (read_csv()), passando o endereço do Dataset (Dataset/dataset.csv) — utilizamos dois pontos e uma barra (../), considerando que tivemos que sair de uma pasta e entrar em outra. Na sequência, inserimos um separador (sep) diferenciado, ponto e vírgula (;).

Preenchida a célula, acionaremos "Shift + Enter". Após rodar o comando, para pegar os cinco primeiros registros do Dataset, preencheremos a célula de "Visualizar os dados" da seguinte forma:

dados.head()

Como resultado, teremos uma tabela:

ValorAreaDist_PraiaDist_Farmacia
046000002800.2409250.793637
19000002080.9041360.134494
225500001700.0595250.421118
35500001002.8831810.525064
422000001640.2397580.192374

Nela, encontramos as variáveis com as respectivas unidades de medida apresentadas anteriormente. Continuaremos, preenchendo a célula de "Verificando o tamanho do dataset" com:

dados.shape

Ao executar, obteremos:

(5000, 4)

Ou seja, são 5000 observações e 4 variáveis.

Acabamos de conhecer o Dataset, o nosso projeto. Com base nele, estimaremos o modelo de Regressão Linear para tentar prever o valor dos imóveis, a partir das três características iniciais — Area, Dist_Praia e Dist_Farmacia — propostas.

Assim, geraremos um sistema de avaliação imobiliário, utilizando técnicas de Machine Learning, no caso, a Regressão Linear. Essa é a ideia do nosso projeto.

Como dito anteriormente, seguiremos o mesmo procedimento do curso anterior, só que com algumas modificações.

Antes, a ideia era desenvolver sensibilidade para uma análise de dados mais visual, com base em comportamento de dados e em padrões lineares entre as variáveis. Agora, a ideia é conhecer mais algumas coisas, como as transformações de dados para poder rodar modelos lineares — considerando que alguns não possuem um padrão linear entre as variáveis dependentes e as variáveis explicativas. Portanto, estudaremos como realizar algumas transformações para fazer funcionar. Além disso, serão apresentados alguns testes mais formais do que os do curso anterior, baseados em testes de hipótese com algumas estatísticas de aceitação e rejeição dos testes.

Adiante, no item "1.3 Análises Preliminares", começaremos a analisar os dados para ter uma ideia do comportamento dos dados.

Análises preliminares - Análises preliminares

A seguir, iniciaremos uma análise preliminar dos dados, uma análise descritiva, que é muito importante em qualquer projeto de regressão linear. Precisamos entender como os dados se comportam, qual a variação e a correlação entre eles.

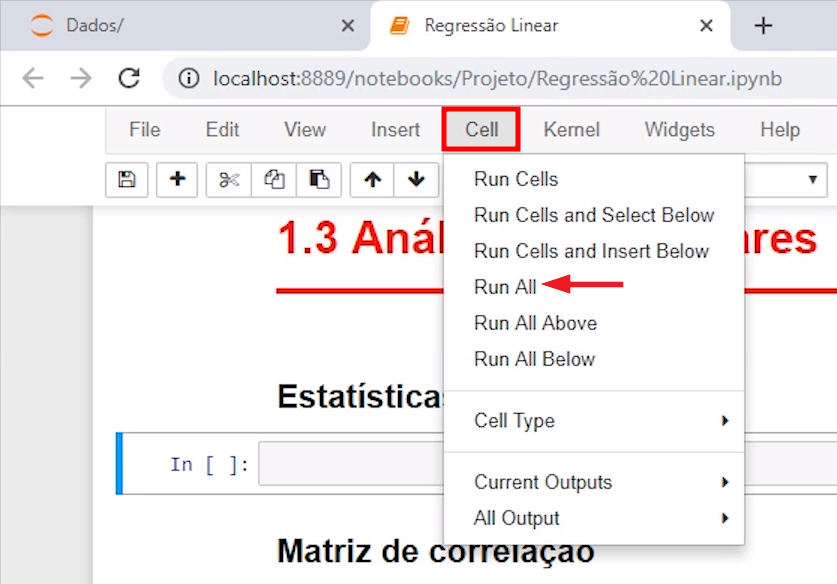
Primeiro, preencheremos a célula de "Estatísticas descritivas", no item "1.3 Análises Preliminares". Lembrando que, caso tenha fechado o notebook, após abrir o projeto novamente, clique em "Cell > Run All", no menu superior. Assim, as células preenchidas anteriormente serão executadas, colocando nosso DataFrame dados na memória.

Continuando, preencheremos a célula de "Estatísticas descritivas". Utilizaremos describe() e round(2) para limitar o número de casas decimais, melhorando a nossa análise.

dados.describe().round(2)

Ao executar, obteremos a seguinte tabela:

ValorAreaDist_PraiaDist_Farmacia
count5000.005000.005000.005000.00
mean1402926.39121.943.020.50
std1883268.8590.543.170.29
min75000.0016.000.000.00
25%460000.0070.000.440.24
50%820000.0093.001.480.50
75%1590000.00146.005.610.75
max25000000.002000.0017.961.00

Nesse grupo de estatísticas, na primeira linha, temos uma contagem (count) que está de acordo com o número de observação (5000.00) que obtivemos anteriormente. Abaixo, encontramos as linhas para:

  • média (mean);
  • desvio padrão (std);
  • valor mínimo (min);
  • primeiro quartil (25%);
  • mediana (50%);
  • terceiro quartil (75%);
  • valor máximo (max).

Na coluna de Valor, encontramos um valor máximo um pouco estranho, de 25000000.00 — vinte e cinco milhões — de reais. Pode ser que exista, já que estamos tratando de dados da cidade Rio de Janeiro, na qual existem imóveis muito caros. Mas, o foco do curso não é tratamento de outliers. Lidaremos com isso como se já estivesse tratado — se você fez o curso de Pandas, conhece ao menos uma técnica para tratamento. Enfim, não abordaremos tratamento de outliers neste curso. No entanto, fique à vontade para aplicar um tratamento para melhorar os resultados da regressão que obteremos no projeto. Inclusive, será bem legal se você aplicar algum.

Na coluna de Area também encontramos um valor que causa estranhamento. Um apartamento de 2000.00m². Pode ser que também exista, mas é um valor um tanto exagerado, que não parece real. Mas, vamos deixar isso de lado, por enquanto.

As colunas seguintes são as de Dist_Praia e Dist_Farmacia, ambas medidas e quilômetros. Nelas, encontramos valores mais aceitáveis na linha de max. A linha de min dessas colunas apresentam 0.00, ou seja, estão bem situados — muito próximo à praia e à farmácia.

Feita a análise preliminar, partiremos para a Análise de Correlação, que é uma análise de associação linear, entre duas variáveis. Para isso, na célula de "Matriz e correlação", digitaremos:

dados.corr().round(4)

Assim, criaremos a matriz de correlação (corr()), limitando o número de casas decimais a quatro (round(4)). Ao executar, obteremos a seguinte matriz:

ValorAreaDist_PraiaDist_Farmacia
Valor1.00000.7110-0.3665-0.0244
Area0.71101.0000-0.2834-0.0310
Dist_Praia-0.3665-0.28341.00000.0256
Dist_Farmacia0.02440.03100.02561.0000

O objetivo é identificar a correlação entre as variáveis e a direção dessa correlação. Lembrando que esse valor vai de -1 a 1, onde -1 é uma associação negativa perfeita e 1 é uma associação positiva perfeita. Vale ressaltar que 1 positivo não significa que todos os dados estão subindo. A associação positiva significa que os dados vão na mesma direção, ou seja, quando um sobe, o outro sobe também ou quando um desce, o outro desce também. Já a associação negativa é o contrário da positiva: quando um sobe, o outro desce.

Inicialmente, a linha que analisaremos é a de Valor, porque é a nossa variável dependente. Lembre-se que estamos criando um sistema de avaliação imobiliário e ela será nosso Y, considerando que queremos estimar o valor dos imóveis. A correlação com:

  • Area é de 0.7110 (70%), bastante alta e positiva, o que faz sentido: quanto maior a Area, maior o Valor;
  • Dist_Praia é mais fraca, -0.3665, de quase 40% e negativa, o que também faz sentido, pois quanto mais distante da praia, menor o Valor;
  • Dist_Farmacia é um tanto baixa, -0.0244, além de negativa. Faz sentido, apesar de muito baixa. Investigaremos com mais atenção se essa variável faz sentido ou não quando chegarmos nos testes formais e codarmos a regressão.

Algo importante que precisamos examinar é se as variáveis explicativas não estão muito correlacionadas entre si. Isso pode ser um problema, como vimos no curso anterior.

Na linha de Area, há uma correlação negativa de quase 30%(-0.2834), não tão alta. Em Dist_Farmacia permanece baixa, mas tudo bem. Analisando os valores de Dist_Praia e Dist_Farmacia, percebemos que as variáveis não estão muito correlacionadas entre si, o que é um ponto positivo.

Adiante, começaremos a a analisar o comportamento da variável dependente (Y), entendendo porquê precisamos analisar os dados e verificar se eles precisam, de fato, da transformação.

Sobre o curso Regressão Linear: técnicas avançadas de modelagem

O curso Regressão Linear: técnicas avançadas de modelagem possui 107 minutos de vídeos, em um total de 50 atividades. Gostou? Conheça nossos outros cursos de Exploração de Dados em Dados, ou leia nossos artigos de Dados.

Matricule-se e comece a estudar com a gente hoje! Conheça outros tópicos abordados durante o curso:

  • Análises preliminares
  • Análises gráficas
  • Transformação de variáveis
  • Regressão linear com StatsModels
  • Regressão linear com Scikit Learn

Aprenda Exploração de Dados acessando integralmente esse e outros cursos. Comece hoje!

Plus 24

Todos os cursos, trilhas e certificados para evoluir.

Carregando precos do plano

7 dias para cancelar com reembolso

Alura EmpregabilidadeNOVO
  • Acesso ao maior portal de vagas tech do BrasilExclusivo na Black
  • Modo entrevista técnica e comportamental
  • 2.348 Cursos e 37 Carreiras
  • Certificados reconhecidos pelo mercado
  • Luri: nossa IA exclusiva, que acelera e personaliza seu aprendizado

Pro 24

Aprenda mais rápido com IA, idiomas e imersões.

Carregando precos do plano

7 dias para cancelar com reembolso

TUDO DO PLUS, MAIS:

Alura EmpregabilidadeNOVO
  • Acesso ao maior portal de vagas tech do Brasil
  • Modo entrevista técnica e comportamental
  • Desafios de código
  • System design
  • Luri Vision: a versão mais completa da nossa IA, que permite envio de imagens
  • Livros da Casa do código: Acesso ao acervo de livros da maior editora tech do país
  • Alura Língua: cursos de inglês e espanhol com foco na área tech

Ultra Lab 24

Aceleração de carreira: mentoria, vagas e prática guiada.

Carregando precos do plano

7 dias para cancelar com reembolso

TUDO DO PRO, MAIS:

Alura EmpregabilidadeNOVO
  • Acesso ao maior portal de vagas tech do Brasil
  • Modo entrevista técnica e comportamental
  • Desafios de código
  • System design
  • 2 mentorias individuais com foco na sua carreira
  • Luri Vision Ilimitada: a versão mais completa da nossa IA
  • Lives CareerUp: eventos exclusivos com foco em empregabilidade e carreira
Melhor opção para a sua carreira
Conheça os Planos para Empresas