Spark NLP: aprenda a otimizar a linguagem natural com eficácia
9 minutos de leitura

Você já pensou como podem ser analisados os comentários nas redes sociais? Imagine que você é a pessoa responsável por desenvolver um projeto que analisa as redes sociais de uma empresa ou de um influencer. Nesse cenário, você terá que trabalhar com uma grande quantidade de dados, denominada Big Data, com enfoque em textos.
Para isso, vamos fazer uso de uma técnica denominada Processamento de Linguagem Natural (PLN), mais conhecido pelo termo em inglês Natural Language Processing (NLP). Podemos definir Linguagem Natural como a maneira que nós nos comunicamos uns com os outros, e ela está presente em textos, letras de músicas, e-mails, entre outros. Dentro da inteligência artificial, o processamento de linguagem natural é a área que se dedica a traduzir a linguagem humana para uma linguagem que os dispositivos tecnológicos consigam entender.
Para trabalharmos com essa grande quantidade de dados textuais, uma alternativa é recorrer a alguma ferramenta performática nesse âmbito, é aí que entra o Apache Spark. Apache Spark é uma ferramenta Big Data que possui como principal objetivo realizar o processamento paralelo e distribuído de grandes conjuntos de dados.
O Spark oferece nativamente alguns métodos para se trabalhar com NLP através do MLlib. Porém, para a construção de um modelo NLP mais robusto utilizando técnicas como Stemming e Lemmatization, alguns outros módulos são necessários e não estão disponíveis de forma nativa. Muitas vezes, quando tentamos utilizar o Spark para NLP em determinadas tarefas intermediárias, temos que utilizar outras bibliotecas e depois voltar ao Spark. Isso acarreta em uma divisão de processamento e consequentemente maior gasto de tempo. Pensando nisso, foi desenvolvida a biblioteca Spark NLP, que estende nativamente as funcionalidades da MLlib.
Spark NLP é uma biblioteca de processamento de linguagem natural de última geração que foi construída sobre o Apache Spark. Este artigo tem como principal enfoque demonstrar a utilização desta biblioteca para realizar alguns pré-processamentos de dados com recursos utilizados em NLP.
Para entendermos o funcionamento e a utilização da biblioteca, vamos trabalhar com um pequeno exemplo. A primeira etapa é a instalação do pacote Spark NLP e PySpark. Nesse artigo, iremos utilizar as versões 4.0.1 para o Spark NLP e 3.3.0 para o PySpark. Vamos fazer isso através do gerenciador de pacotes pip:
pip install -q pyspark==3.3.0 spark-nlp==4.0.1
Após finalizadas as instalações, vamos importar o pacote e criar uma sessão do Spark NLP:
import sparknlp
spark = sparknlp.start()
Agora, o próximo passo é a criação de um DataFrame para observarmos as aplicações dos métodos. O DataFrame de exemplo terá o nome de três bandas em uma coluna e um trecho de uma música de cada uma das bandas em outra coluna. Fique à vontade para tentar acertar qual música é.
data = [("The Beatles", "There are places I'll remember "+
                        "All my life though some have changed "+
                        "Some forever, not for better "+
                        "Some have gone and some remain"),
        ("Oasis", "So I start a revolution from my bed " +
                  "Cause you said the brains I had went to my head " +
                  "Step outside, summertime's in bloom "+
                  "Stand up beside the fireplace"),
        ("Pink Floyd", "How I wish you were here " +
                        "We're just two lost soul " +
                        "Swimming in a fish bowl year after year " +
                        "Running over the same old ground")]
df_musica = spark.createDataFrame(data, ["artista", "letra"])
Pronto! Agora que já estamos com o DataFrame criado e com a sessão Spark iniciada, podemos começar o tratamento dos dados, portanto, vamos importar os pacotes que serão utilizados.
from sparknlp.annotator import LemmatizerModel, Stemmer, Tokenizer, StopWordsCleaner
from sparknlp.base import DocumentAssembler
DocumentAssembler
O DocumentAssembler é o método responsável por pegar os dados de textos no formato bruto e fazer a conversão em um formato que poderá ser processado pelo Spark NLP sendo portanto o ponto de entrada do pipeline do Spark NLP. O código utilizando o DocumentAssembler, será:
document_assembler = DocumentAssembler()\\
                       .setInputCol("letra")\\
                       .setOutputCol("document")
doc_df = document_assembler.transform(df_musica)
doc_df.select("document.result").show(truncate=False)
O método .setInputCol() define qual será a coluna de entrada e .setOutputCol() define qual será o nome da coluna de saída. Como os dados que queremos realizar os tratamentos estão na coluna "letra" então vamos passar essa coluna para .setInputCol() e vamos chamar a coluna de saída de "document". O código acima terá como saída:
+-------------------------------------------------------------------------------------------------------------------------------------------------------+
|result                                                                                                                                                 |
+-------------------------------------------------------------------------------------------------------------------------------------------------------+
|[There are places I'll remember All my life though some have changed Some forever, not for better Some have gone and some remain]                      |
|[So I start a revolution from my bed Cause you said the brains I had went to my head Step outside, summertime's in bloom Stand up beside the fireplace]|
|[How I wish you were here We're just two lost soul Swimming in a fish bowl year after year Running over the same old ground]                           |
+-------------------------------------------------------------------------------------------------------------------------------------------------------+

Tokenizer
A tokenização é o tratamento que consiste em dividir uma frase em palavras ou tokens individuais.
tokenizer = Tokenizer()\\
              .setInputCols(["document"])\\
              .setOutputCol("token")
token_df = tokenizer.fit(doc_df).transform(doc_df)
token_df.select('token.result').show(truncate=False)
A saída do código será:
+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|result                                                                                                                                                                               |
+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|[There, are, places, I'll, remember, All, my, life, though, some, have, changed, Some, forever, ,, not, for, better, Some, have, gone, and, some, remain]                            |
|[So, I, start, a, revolution, from, my, bed, Cause, you, said, the, brains, I, had, went, to, my, head, Step, outside, ,, summertime's, in, bloom, Stand, up, beside, the, fireplace]|
|[How, I, wish, you, were, here, We're, just, two, lost, soul, Swimming, in, a, fish, bowl, year, after, year, Running, over, the, same, old, ground]                                 |
+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
Percebemos que antes, os elementos estavam todos dentro da lista como uma única frase, agora, as palavras estão separadas por vírgulas como elementos individuais dentro da lista.
Removendo stop words
Stop words são as palavras cuja frequência ou sua semântica não possuem significado, ou pouco significado. Como em NLP buscamos identificar as palavras que mais vão contribuir para a diferenciação de um texto para outro e como as stop words são palavras que aparecem com frequência na maioria dos textos, fazer a remoção dessas palavras que não nos acrescentam informações é uma ótima prática. Para fazer isso utilizando a biblioteca Spark NLP, o código será:
stopwords_cleaner = StopWordsCleaner()\\
      .setInputCols("token")\
      .setOutputCol("cleanTokens")
token_df_clean = stopwords_cleaner.transform(token_df)
token_df_clean.select("cleanTokens.result").show(truncate=False)
A saída produzida pelo código acima será:
+--------------------------------------------------------------------------------------------------------------------------+
|result                                                                                                                    |
+--------------------------------------------------------------------------------------------------------------------------+
|[places, remember, life, though, changed, forever, ,, better, gone, remain]                                               |
|[start, revolution, bed, Cause, said, brains, went, head, Step, outside, ,, summertime's, bloom, Stand, beside, fireplace]|
|[wish, two, lost, soul, Swimming, fish, bowl, year, year, Running, old, ground]                                           |
+--------------------------------------------------------------------------------------------------------------------------+
Podemos perceber que a saída agora está menor, se compararmos com a saída produzida pelo tokenizer. Algumas palavras foram removidas, como por exemplo, “there”, “all”, “my”, “some”, “so”, entre outras. Para obter todas as stop words consideradas pelo Spark NLP podemos fazer uso do método .getStopWords():
stopwords_cleaner.getStopWords()
Stemmer
É uma técnica utilizada para reduzir as palavras à sua forma raiz, dessa forma reduz ainda mais os ruídos presentes. Por exemplo, changing, changed (mudando, mudado) seriam substituídas pela palavra chang, pois todas possuem essa palavra raiz. Para fazer isso no Spark NLP, o código será:
stemmer = Stemmer() \\
    .setInputCols(["cleanTokens"]) \\
    .setOutputCol("stem")
stem = stemmer.transform(token_df_clean)
stem.select("stem.result").show(truncate=False)
A saída será:
+-----------------------------------------------------------------------------------------------------------------+
|result                                                                                                           |
+-----------------------------------------------------------------------------------------------------------------+
|[place, rememb, life, though, chang, forev, ,, better, gone, remain]                                             |
|[start, revolut, bed, caus, said, brain, went, head, step, outsid, ,, summertime', bloom, stand, besid, fireplac]|
|[wish, two, lost, soul, swim, fish, bowl, year, year, run, old, ground]                                          |
+-----------------------------------------------------------------------------------------------------------------+
Comparando com a saída produzida no tópico “Removendo Stopwords”, percebemos que a “changed” foi substituída por “chang”, “revolution” por “revolut”, “remember” por “rememb”, entre outras. Uma característica dessa técnica é a possibilidade da palavra reduzida ser gramaticalmente incorreta ou simplesmente não existir no idioma, o que pode ser um problema dependendo do que estamos procurando resolver. Em casos assim, podemos utilizar outra técnica chamada lemmatization.
Lemmatizer
Essa técnica leva em consideração a análise morfológica, que estuda a classe gramatical das palavras existentes em uma frase. Nessa técnica, também buscamos reduzir a palavra a sua forma raiz.
Nessa técnica, a palavra gerada sempre existirá e sua classe gramatical será analisada ao fazer a redução, diferentemente do stemmer que pode gerar palavras inexistentes, ao reduzir duas palavras com significados diferentes ao mesmo radical.
Para fazer isso, é necessário ter um dicionário detalhado que possa ser consultado pelo algoritmo antes da redução da palavra. Vamos fazer uso de um modelo pré-treinado do Spark NLP que já possui o dicionário em inglês que precisamos. Um exemplo de código usando lemmatizer será o trecho abaixo:
lemmatizer = LemmatizerModel.pretrained() \\
              .setInputCols(["cleanTokens"]) \\
              .setOutputCol("lemma")
result = lemmatizer.transform(stem)
result.select("lemma.result").show(truncate=False)
O código acima produzirá a saída:
+----------------------------------------------------------------------------------------------------------------------+
|result                                                                                                                |
+----------------------------------------------------------------------------------------------------------------------+
|[place, remember, life, though, change, forever, ,, well, go, remain]                                                 |
|[start, revolution, bed, Cause, say, brain, go, head, Step, outside, ,, summertime's, bloom, Stand, beside, fireplace]|
|[wish, two, lose, soul, Swimming, fish, bowl, year, year, Running, old, ground]                                       |
+----------------------------------------------------------------------------------------------------------------------+
Conclusão
Bem, agora você já conhece mais sobre a biblioteca Spark NLP e algumas de suas ferramentas não-nativas ao MLlib, como stemmer e lemmatizer, que ajudam na construção de modelos mais robustos que utilizem linguagem natural. Percebemos também que, após todas as reduções, a quantidade de dados que será utilizada para os modelos de machine learning foi bastante reduzida.
A biblioteca Spark NLP possui diversas outras funcionalidades que a tornam a biblioteca para NLP mais utilizada nas organizações, como mostra a página inicial de sua documentação. Conforme podemos constatar abaixo:
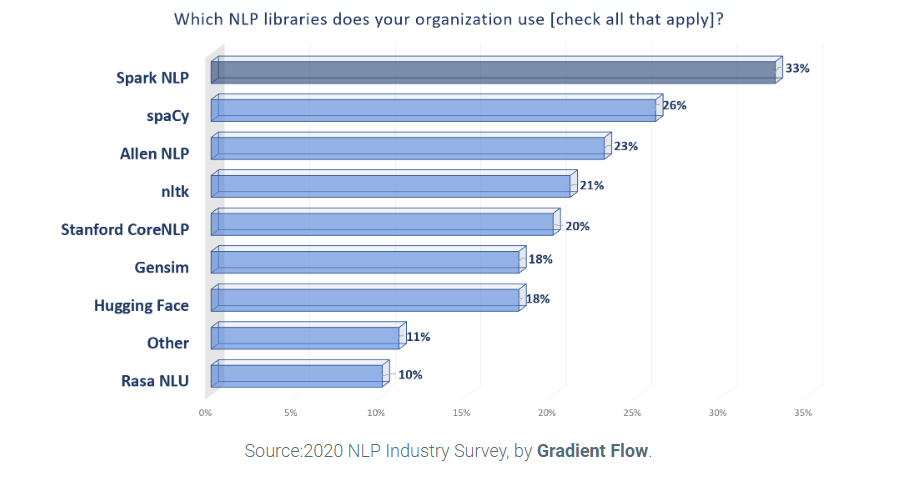
Uma boa dica é tirar um tempo e navegar pelo site conhecendo essas e outras funcionalidades.
Para saber ainda mais sobre a aŕea de NLP, deixamos como sugestão a seguinte formação:
Sugerimos também a leitura dos artigos:
Você também pode conferir o código desenvolvido no artigo no GitHub através desse link.
Créditos:
Escrita:
Produção técnica:
Produção didática:
Avalie este artigo

Autor(a)
Bruno Raphaell
Bruno é um instrutor de Data Science e Engenheiro Eletricista pela Universidade Federal do Piauí. Se dedica em áreas como Data Science, Machine Learning e Deep Learning, e possui grande interesse em engenharia de dados e engenharia de machine learning. Além disso, em seu tempo livre, ele gosta de jogar xadrez, tocar instrumentos musicais e jogar League of Legends.


Inscreva-se em nossa Newsletter
Fique por dentro de conteúdos, insights e oportunidades do universo tech. Receba novidades e lançamentos direto no seu e-mail.