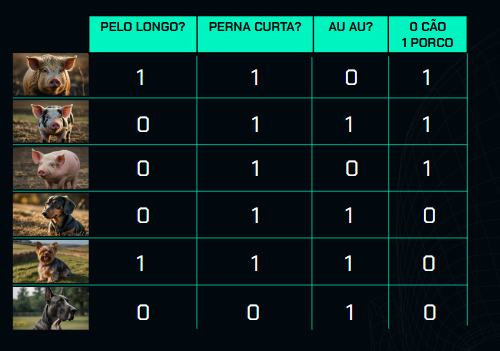
Continuando o curso, a ideia agora é implementar o primeiro estimador. Vamos treinar e demonstrar o aprendizado de máquina em ação.
Para isso, utilizaremos o Google Colab, um ambiente onde é possível escrever código em Python sem a necessidade de instalação local.
Acessando o site do Colab pelo navegador, uma janela modal será exibida, na qual é possível criar um novo notebook (caderno), onde serão feitas anotações em Python. Esse notebook permitirá a escrita de código e texto.
Ao criar um novo notebook clicando no botão "Novo notebook", será gerado um espaço, chamado célula, para escrever códigos em Python.
Adicionando os animais
Nela, podemos declarar a seguinte variável como exemplo:
Para executar uma célula de código, basta pressionar "Shift + Enter" ou clicar no botão de play à esquerda de cada célula. O código será executado na nuvem do Google, que se conectará a uma máquina virtual.
Após executar a célula de exemplo, outra será gerada abaixo dela. Nesse momento, voltaremos à primeira para definir os itens.
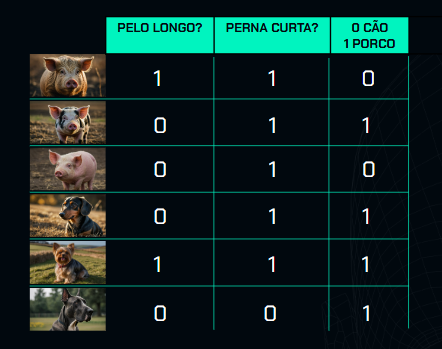
Cada item é uma linha que será utilizada para treinamento e aprendizado. O porco1 possui três características que adicionaremos numa lista ou array, representado por um par de colchetes:
Isso indica que o primeiro porco não tem pelo longo (0), tem perna curta (1) e não faz "au, au" (0). Da mesma forma, definiremos porco2 e porco3 nas linhas seguintes, ainda na primeira célula:
porco1 = [0, 1, 0]
porco2 = [0, 1, 1]
porco3 = [1, 1, 0]
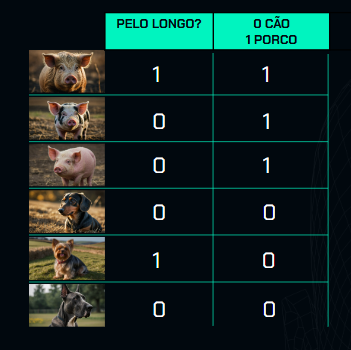
As features (características) são: pelo longo, perna curta e faz "au, au", onde 1 significa sim e 0 significa não. Vamos adicioná-las acima das variáveis dos porcos, em formato de comentário.
Para criar um comentário, basta adicionar uma cerquilha (#) no início da linha.
porco1 = [0, 1, 0]
porco2 = [0, 1, 1]
porco3 = [1, 1, 0]
Abaixo dos porcos, também definimos os três cachorros:
porco1 = [0, 1, 0]
porco2 = [0, 1, 1]
porco3 = [1, 1, 0]
cachorro1 = [0, 1, 1]
cachorro2 = [1, 0, 1]
cachorro3 = [1, 1, 1]
Criando uma lista de dados
Abaixo dos porcos e cachorros, ainda na mesma célula, os dados (que são os seis animais) serão armazenados em uma lista:
dados = [porco1, porco2, porco3, cachorro1, cachorro2, cachorro3]
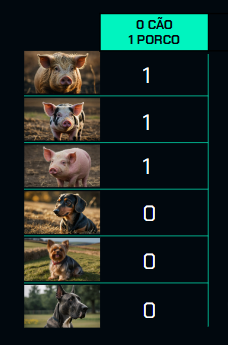
Para o aprendizado supervisionado, é necessário definir as classes. Nesse caso, 1 representará porco e 0, cachorro.
dados = [porco1, porco2, porco3, cachorro1, cachorro2, cachorro3]
classes = [1, 1, 1, 0, 0, 0]
A célula completa pode ser consultada abaixo:
porco1 = [0, 1, 0]
porco2 = [0, 1, 1]
porco3 = [1, 1, 0]
cachorro1 = [0, 1, 1]
cachorro2 = [1, 0, 1]
cachorro3 = [1, 1, 1]
1 -> porco, 0 -> cachorro
dados = [porco1, porco2, porco3, cachorro1, cachorro2, cachorro3]
classes = [1, 1, 1, 0, 0, 0]
Vamos rodá-la com "Shift + Enter". Na linha seguinte, podemos executar a dados para consultar essa lista:
Retorno:
[[0, 1, 0], [0, 1, 1], [1, 1, 0], [0, 1, 1], [1, 0, 1], [1, 1, 1]]
Em seguida, eliminaremos essa célula de consulta, clicando no ícone de lixeira chamado "Excluir célula", à sua direita.
Treinando o modelo
Para ensinar a máquina, precisaremos de um estimador — ou seja, um modelo de máquina com algoritmos matemáticos que nunca calculou nada. Para isso, acessaremos a próxima célula e adicionaremos o modelo.
Para esse modelo, escolheremos um tipo de modelo de aprendizagem de máquina — no caso, o LinearSVC().
Precisamos importar esse modelo da biblioteca sklearn (scikit-learn). Para isso, escreveremos from sklearn.svm import LinearSVC acima do modelo.
from sklearn.svm import LinearSVC
modelo = LinearSVC()
Essa biblioteca já vem instalada no Google Colab. Caso queira instalá-lo na sua máquina, basta acessar o link abaixo:
Se rodarmos essa célula, nada ocorrerá. Abaixo do modelo, na mesma célula, temos que pedir ao modelo que treine com um .fit(dados), encaixando os dados no modelo de animal que ela possui.
Por ser um aprendizado supervisionado, também precisamos encaixar as classes às quais os animais são correspondentes. Com isso, solicitamos um treinamento com base nos dados e classes informadas.
from sklearn.svm import LinearSVC
modelo = LinearSVC()
modelo.fit(dados, classes)
Após rodar o treinamento com "Shift + Enter", o modelo terá conhecido alguns animais. Após isso, podemos realizar previsões.
Prevendo um animal
Por exemplo, para um animal misterioso com características [0, 1, 1], pediremos que o modelo preveja se é um cachorro ou um porco com o predict(). Como queremos somente um animal, informaremos entre os parênteses uma lista que terá somente o animal misterioso:
animal_misterioso = [0, 1, 1]
previsao = modelo.predict([animal_misterioso])
Após executar essa célula, o modelo prevê que este animal de pelos curtos, pernas curtas e que faz "au, au" é um cachorro (0).
Conseguimos treinar o modelo nos dados e classes, de forma supervisionada e realizar o primeiro teste. Contudo, um único teste não é o suficiente: precisamos de uma nota para saber se o algoritmo está bem treinado ou não.
Numa prova, calculamos a nota fornecendo exercícios e contando o percentual de acertos. Aplicaremos esse cálculo no modelo
Calculando a acurácia da previsão
Para calcular a acurácia, criaremos três animais de teste que terão uma lista de características. Em seguida, adicionaremos os animais em uma lista.
Por fim, pediremos ao modelo que faça previsões, por meio de um modelo.predict() dos testes.
misterio1 = [1, 1, 1]
misterio2 = [1, 1, 0]
misterio3 = [0, 1, 1]
testes = [misterio1, misterio2, misterio3]
previsoes = modelo.predict(testes)
Após rodar a célula, informaremos na célula seguinte que as classes reais para os testes são 0, 1 e 1 (cachorro, porco e porco). Antes disso, o modelo não sabia essas classes e tentou prever.
testes_classes = [0, 1, 1]
Após executar essa célula, conferiremos as estimativas do modelo antes de saber as respostas:
array([0, 1, 0])
Ele errou uma classe de três. Ou seja, a taxa de acerto, que chamamos de acurácia, está em 66,6%.
Para chegar a esse número, tentaremos comparar cada elemento de previsoes com testes_classes.
previsoes == testes_classes
Retorno:
array([True, True, False])
A partir desse retorno, contaremos o total de respostas verdadeiras, somando o previsoes == testes_classes.
(previsoes == testes_classes).sum()
Retorno
2
O resultado é dois, pois verdadeiros valem 1 e falsos valem 0. Ou seja, este comando equivale aos corretos.
corretos = (previsoes == testes_classes).sum()
total = len(testes)
previsoes = modelo.predict(testes)
O total é a quantidade de testes — ou seja, len(testes). Já a taxa_de_acerto (acurácia) equivale ao corretos dividido pelo total e multiplicado por 100.
Por fim, imprimiremos a acurácia digitando taxa_de_acerto.
previsoes = modelo.predict(testes)
len(testes)
taxa_de_acerto = corretos / total * 100
taxa_de_acerto
Retorno:
66.6666666666666
Para imprimir melhor, substituiremos o taxa_de_acerto por um print(f"Acurácia: {taxa_de_acerto:.2f}%"), onde f informa que usamos uma variável dentro do texto, e :.2f informa que queremos o resultado com duas casas decimais.
previsoes = modelo.predict(testes)
len(testes)
taxa_de_acerto = corretos / total * 100
print(f"Acurácia: {taxa_de_acerto:.2f}%")
Retorno:
Acurácia: 66.67%
Conclusão e próximos passos
Conseguimos treinar um modelo com alguns itens e prever sua acurácia, o que é fundamental para algoritmos de aprendizado supervisionado. A seguir, vamos melhorar e explorar outros exemplos.