Carregamos os dados e agora chegou o momento de entender qual é a relação de cada uma dessas variáveis que temos com o valor dos automóveis. Será que a gente tem uma relação linear, ou seja, conforme o valor da variável aumenta, o valor do automóvel também aumenta? É isso que a gente vai descobrir agora. Vamos entender como essas variáveis influenciam o valor dos automóveis.
Para isso, podemos criar alguns gráficos para cada uma das variáveis para entender essas relações. Se considerarmos o estilo do automóvel, que é a primeira variável, temos as categorias. Será que tem algum estilo que é mais caro que outro? Como que isso acontece?
Podemos criar, por exemplo, um gráfico de colunas que mostre a média de valor por estilo, obtendo insights a partir disso. Então, vamos criar alguns gráficos, começando pelo estilo.
Criando gráfico de estilo
Antes de começar, podemos definir as configurações da largura e altura dos gráficos para termos uma boa visualização. Então, digitamos options(repr.plot). Primeiro, definiremos a largura, então escrevemos width = 10. Adicionamos vírgula e definimos a altura repr.plot.height = 6 e executamos.
options(repr.plot.width = 10, repr.plot.height = 6)
Se queremos criar primeiro um gráfico de colunas do estilo com a média do valor, precisamos chamar nossos dados. Precisamos agrupar esses automóveis conforme o estilo. Então, usaremos o operador pipe dados %>%. Na linha abaixo, usaremos a função group_by(). Nos parênteses, passamos Estilo e fora passamos o pipe novamente %>%.
Agrupamos por estilo, mas queremos a média de valor pra cada categoria que temos. Usaremos uma função chamada summarise(). Nos parênteses, criamos a variável media_Valor. Adicionamos o sinal de igual e passamos a média, que é mean(). Para essa função, passamos a coluna Valor, para obter essas médias. Na mesma linha, passamos %>%.
Abaixo, criaremos o gráfico chamando ggplot(). Nos parênteses, chamamos aes() para definir os eixos, então passamos x = Estilo. Inclusive, podemos pedir pra ordenar da maior média pra menor, pra ter um gráfico mais fácil de visualizar e conseguir obter algum insight.
Para fazermos essa ordenação, antes do Estilo, passamos o reorder(), envolvendo o Estilo e também passando a media_valor. Adicionamos vírgula e definimos y = media_valor.
Fora dos parênteses, na mesma linha, adicionamos o sinal de +, na linha seguinte, definiremos o tipo de gráfico que criaremos, nesse caso o de colunas. Escrevemos geom_col() + e pulamos para a próxima linha.
Também podemos pedir pra deixar esse gráfico com as colunas na horizontal pra ficar mais fácil de visualizar. Para isso, escrevemos coord_flip() +, para que rotacione.
Na linha abaixo, definiremos os rótulos dos eixos passando labs(). Começaremos com o título, então, nos parênteses escrevemos title = ''Média do valor por estilo do automóvel. Adicionamos vírgula e passamos o rótulo do eixo x vazio, x = ''. Entenderemos o motivo disso depois.
Na linha abaixo, passamos y = 'Média do valor'. Por fim, para o gráfico ficar bem completo, podemos colocar um tema para conseguir modificar algo, como o tamanho da fonte. Porque o tamanho da fonte vai ficar pequeno, se quisermos um pouco maior, podemos alterar da seguinte forma. Na última linha, passamos theme(text = element_text(size = 16)).
dados %>%
  group_by(Estilo) %>%
  summarise(media_valor = mean(Valor)) %>%
  ggplot(aes(x = reorder(Estilo, media_valor), y = media_valor)) +
  geom_col() +
  coord_flip() +
    labs(title = 'Média do valor por estilo do automóvel',
         x = '',
         y = 'Média do valor') +
           theme(text = element_text(size = 16))
Após executar, temos o seguinte gráfico.
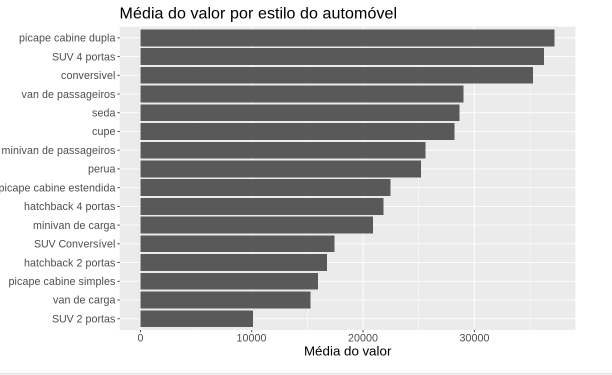
Temos a média do valor por estilo do automóvel. Como média de maior valor temos a picape de cabine dupla, seguido do SUV 4 portas, conversível e outros. Já automóveis com valores mais baixos temos Hatchback 2 portas, picape cabine simples, Van de carga e SUV 2 portas. Então, a partir desse gráfico, conseguimos entender que sim, o estilo do automóvel tem uma influência em relação ao ao valor dele.
Avaliando o impacto do ano do automóvel no valor
Agora, vamos seguir para a próxima variável, o ano. Vamos descobrir se quanto mais velho o automóvel, mais barato é. Para isso, escrevemos ggplot(dados, aes(x = Ano, y = Valor)). Usaremos o gráfico de pontos. Adicionamos o sinal de + e na próxima linha chamamos geom_point() e executamos.
ggplot(dados, aes(x = Ano, y = Valor)) +
  geom_point()
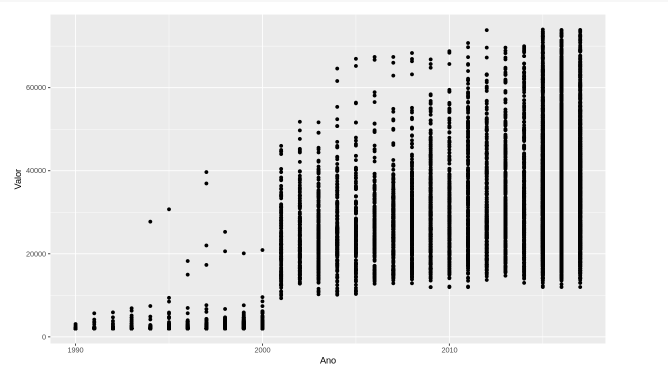
Conseguimos notar que até o ano 2000 temos valores mais baixos, especialmente nos primeiros anos. Quando chega próximo de 2000, temos valores que estão mais dispersos. Há automóveis que são mais antigos, mas tem valor de 20 mil, 40 mil dólares.
Então, mesmo que no começo tenha valores baixos e dispersões nos anos seguintes, os valores aumentam ao longo do tempo, mas não há uma relação linear.
Investigando a relação entre potência do motor e valor
Sabendo disso, vamos checar a próxima variável. Para isso, copiamos o mesmo código da célula acima e colamos na nova célula. Agora, faremos as alterações necessárias. Mudamos o valor de X para Potencia_motor e executamos a célula.
ggplot(dados, aes(x = Potencia_motor, y = Valor)) +
  geom_point()
Assim, temos um resultado diferente, com uma concentração em alguns pontos, seguindo o que parece algo linear. Conforme a potência vai aumentando, o valor também aumenta, embora tenhamos alguns pontos que não estejam tão nesse padrão. Além disso, quando temos a potência do moto alta, acima de 600, há valores que não estão seguindo a reta. Para facilitar nossa visualização, vamos adicionar essa reta.
Para isso, após geom_point() adicionamos + e pulamos para a próxima linha. Nela, escrevemos geom_smooth(method = 'lm'), passando o linear model que vai ajustar uma linha de tendência como se fosse um modelo de regressão linear. Adicionamos vírgula e passamos outros parâmetros, como se = FALSE, que adiciona uma linha de um intervalo de confiança na reta, mas a gente não precisa disso nesse momento. Em seguida, adicionamos color = 'red' e executamos.
ggplot(dados, aes(x = Potencia_motor, y = Valor)) +
  geom_point() +
    geom_smooth(method = 'lm', se = FALSE, color = 'red')
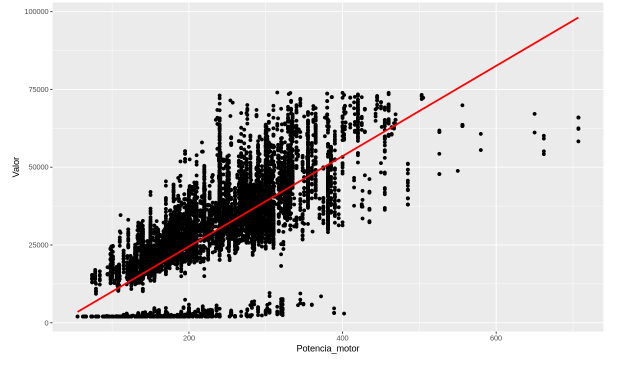
Temos a linha de tendência em vermelho e conseguimos visualizar tudo o que mencionamos anteriormente. Vários dados estão dentro dessa linha, mas temos informações que estão para fora, que são os valores mais altos da potência do motor. Então, temos uma relação que é linear, mas ainda tem alguma dispersão.
Examinando o número de cilindros do motor
Vamos analisar as outras variáveis. Para isso, copiamos a mesma célula anterior. Mudamos o valor de X para Cilindros_motor e executamos.
gplot(dados, aes(x = Cilindros_motor, y = Valor)) +
  geom_point()
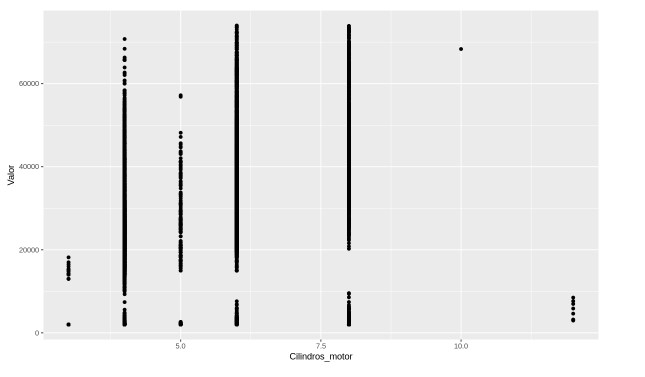
Lembrando que os cilindros iam de 3 até 12 e não tínhamos um padrão em que conseguíamos identificar a linearidade. Agora, quando há um número menor de cilindros, os dados estão com um valor menor, indo até 20 mil dólares. Já quando o cilindro aumenta um pouco o valor também, depois cai. Não temos um padrão em que consigamos extrair algo linear.
Analisando o consumo na estrada e o valor do automóvel
Vamos checar como está a questão do consumo lá na estrada, de quilômetros por litro. Novamente, copiamos o mesmo código e mudamos o valor de x por Consumo_estrada_km.
ggplot(dados, aes(x = Consumo_estrada_km, y = Valor)) +
  geom_point()
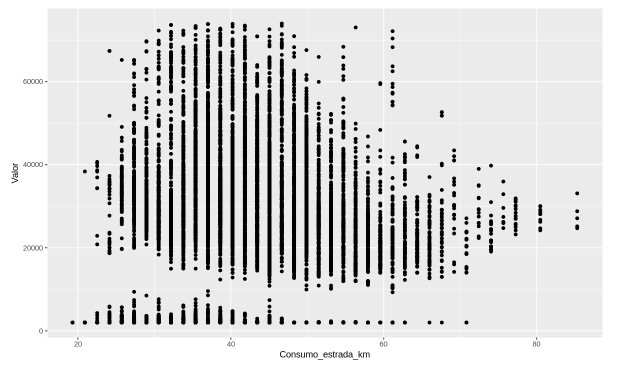
Também temos um padrão que não está seguindo uma linearidade, tem muita dispersão. Inclusive, no final, com o consumo na estrada mais elevado, temos valores mais baixos. Porém, não encontramos um padrão.
Conseguimos analisar tudo isso com gráficos. Agora, podemos aplicar outra técnica, que é analisar a correlação entre essas variáveis para entender como realmente está a associação de cada uma com o valor, pra entender qual está influenciando mais no valor dos automóveis.
Analisando a correlação entre as variáveis
Primeiro, podemos separar só as colunas numéricas. Para isso, criamos a variável dados_numericos <- dados %>% seguido da função select_if(is.numeric), assim, se for numérico, vamos selecionar. Após, criamos a matriz de correlação matriz_correlacao <- cor(dados_numericos). Por fim, chamamos matriz_correlacao e executamos.
dados_numericos <- dados %>% select_if(is.numeric)


matriz_correlacao <- cor(dados_numericos)


matriz_correlacao
| Ano | Potencia_motor | Cilindros_motor | Consumo_estrada_km | Valor |
|---|
| Ano | 1.0000000 | 0.3890908 | -0.1065934 | 0.3577647 | 0.6966555 |
| Potencia_motor | 0.3890908 | 1.0000000 | 0.6952144 | -0.43319516 | 0.7361250 |
| Cilindros_motor | -0.1065934 | 0.6952144 | 1.0000000 | -0.70162167 | 0.3040547 |
| Consumo_estrada_km | 0.3577647 | -0.43319516 | -0.70162167 | 1.0000000 | -0.0475750 |
| Valor | 0.6966555 | 0.7361250 | 0.3040547 | -0.0475750 | 1.0000000 |
Temos esse resultado contendo cada uma das variáveis versus ela mesma. Só que nosso foco será na última linha dessa matriz, a do valor. Vamos comparar a correlação do valor com o ano, que é de 0,70, alta e positiva. Isso indica que quanto maior o ano, maior será o valor do automóvel.
Depois, temos a potência do motor, que tem uma correlação de aproximadamente 0,74, positiva e alta também. Ou seja, quanto maior a potência, maior o valor do automóvel.
Nos cilindros do motor a correlação é positiva, mas baixa. Possui 0,30, ou seja, isso influência muito menos que variáveis como o ano e a potência do motor. Por fim, tem o consumo na estrada em quilômetros por litro, que é de menos 0,04, ou seja, quase nulo. Isso significa que a variável não está influenciando em relação ao valor do automóvel.
Conseguimos extrair muitos insights e entender quais variáveis estão mais associadas e influenciam no preço do automóvel. No próximo vídeo, começaremos a criar nosso primeiro modelo para fazer as previsões dos valores. Bora lá?

