Para começar a analisar dados, precisamos de um caderno em que possamos fazer nossas anotações, cálculos, visualizar os dados e outras tarefas semelhantes.
Para isso, vamos utilizar a linguagem Python e um "caderno", que em inglês é chamado de Notebook. Existem ferramentas online que disponibilizam notebooks para escrevermos em Python. A ferramenta que vamos utilizar será o Google Colab.
Primeiros passos no Colab
Ao entrar nesse site, você pode criar um novo notebook clicando em "Arquivo > Novo Notebook" no canto superior esquerdo da tela. O nome padrão desse novo notebook limpo é "Sem título/Untitled", mas podemos alterá-lo para "Introdução à Ciência de Dados", dando um duplo clique no nome do topo da página.
Podemos fazer anotações nesse notebook, digitando em suas células, que são os campos de texto disponíveis no centro da tela com os dizeres "Comece a programar...". Notem que temos um botão de Play no início da célula, igual ao de reprodução de vídeo. Digitaremos nossos códigos Python dentro desses campos e os executaremos clicando nesse botão de Play.
Por exemplo: em Python, quando queremos criar uma variável, nós digitamos seu nome e a igualamos (com um sinal de igual =) ao seu valor que, se for uma palavra, deverá vir entre aspas duplas.
Então, se quisermos criar a variável nome e atribuir a ela o valor Guilherme, escrevemos o seguinte código na célula:
[1]
Esse é um código Python válido, que diz que a variável nome tem o valor "Guilherme". Podemos executá-lo clicando no botão Play da célula. Com isso, esse código Python será executado na nuvem do Google, e não na nossa máquina.
Podemos criar uma segunda célula para executar um novo código, clicando em "+ Código" no canto superior esquerdo da tela.
Nessa nova célula, vamos imprimir o valor da variável nome. Então, escrevemos:
[2]
E clicamos no botão Play. Feito isso, o nome "Guilherme" é exibido no canto de retorno logo abaixo da célula. Essa segunda execução é mais rápida, porque a máquina já está criada na nuvem do Google.
Podemos criar mais coisas seguindo o mesmo procedimento, por exemplo, uma variável idade com o valor 40, e imprimir o valor dessa variável na mesma célula, na linha de baixo (dando um "Enter" para isso):
[3]
Ao executar, o número "40" é exibido no campo de retorno!
O último código que inserimos em uma célula é impresso para nós. Então, se criarmos uma nova célula e atribuir o valor 42 para a variável idade e, na linha de baixo, apenas digitarmos o nome da variável idade, o novo valor será impresso no campo de retorno ao executarmos a célula.
[4]
Se quisermos executar todos os códigos que escrevemos nesse notebook novamente, nas quatro células, podemos clicar em "Ambiente de execução (ou Runtime, em inglês) > Reiniciar sessão e executar tudo", depois confirmar a ação na caixa de diálogo. Ele vai reiniciar, limpar todas as variáveis e executar tudo de novo.
Se quisermos alterar o valor da variável nome para "Gui", podemos fazer isso editando a nossa primeira célula e clicando no botão Play para executá-la.
[1]
Também podemos usar o atalho "Shift + Enter" para executar apenas essa célula.
Mas, se alteramos o valor de uma célula, provavelmente queremos executar esta célula e as células abaixo, que dependem desse valor atualizado.
Por exemplo, a nossa segunda célula imprime o valor da variável nome, mas não a rodamos novamente depois de atualizar o valor dessa variável, então a impressão ainda é "Guilherme". Nesses casos, é sempre bom reiniciar e rodar tudo de novo.
Essa é a ideia do notebook: ser um lugar onde fazemos as anotações, analisamos os nossos dados e trabalhamos com eles. Vamos fazer isso!
Conjunto de dados do MovieLens
Vamos apagar todas as células, clicando no ícone da lixeira em cada uma delas, à direita, para começar a trabalhar com dados reais. Ficaremos com apenas uma célula limpa no nosso notebook.
Neste curso, vamos trabalhar com dados relacionados a filmes e notas que pessoas deram para esses filmes em suas avaliações. Existe um conjunto de dados famoso chamado MovieLens, que disponibiliza diferentes datasets de avaliações.
Um deles contém 100 mil avaliações de cerca de 9 mil filmes, e é esse arquivo que queremos baixar. Podemos encontrá-lo na seção "recommended for education and development", na versão "Small" (pequena): ml-latest-small.zip.
Quando descompactamos esse arquivo ZIP, encontramos 5 arquivos, incluindo o ratings.csv, que é o arquivo de notas. Vamos abrir esse arquivo num editor de texto apenas para explorá-lo.
Este é um arquivo CSV, o que significa que ele tem vírgulas separando os valores. A primeira linha é um cabeçalho, que indica que temos os seguintes campos no nosso dataset:
- ID do usuário (
userId), que deve ser a pessoa que deu a nota, - ID do filme (
movieId), que deve ser o número do filme, - nota (
rating), - data da atribuição dessa nota (
timestamp).
Isso está representado da seguinte maneira no nosso CSV:
ratings.csv
userId,movieId,rating,timestamp
Cada uma das linhas seguintes representa uma avaliação, cujos valores são referentes a cada um dos campos, respectivamente: usuário, filme, nota e data.
1,1,4.0,964982703
1,3,4.0,964981247
1,6,4.0,964982224
1,47,5.0,964983815
1,50,5.0,964982931
...
Ou seja: o usuário 1 deu para o filme 1 a nota 4.0 no momento 964982703. O mesmo para o filme 3, no momento 964981247. Já para o filme 47, deu nota 5.0 no momento 964983815.
Subindo um dataset para o Colab via CSV
Queremos abrir esse arquivo no nosso notebook. Para facilitar nosso trabalho, vamos usar bibliotecas que facilitam esse processo. Em Python, a biblioteca mais famosa e importante para uso no dia a dia se chama Pandas. Podemos conhecê-la melhor na documentação do Pandas.
No nosso notebook, vamos primeiramente importar o Pandas executando o seguinte código em uma célula:
Queremos ler o nosso arquivo de notas. Para facilitar nosso trabalho, já colocamos esse arquivo na internet, que podemos acessar no seguinte link:
https://raw.githubusercontent.com/alura-cursos/data-science-analise-exploratoria/main/Aula_0/ml-latest-small/ratings.csv
Vamos copiar esse link e retornar ao notebook. Na próxima célula, vamos pedir para o Pandas ler esse arquivo por meio do método read_csv(), passando a URL desse arquivo que acabamos de copiar como parâmetro, entre aspas duplas, resultando em pd.read_csv("https://raw.githubusercontent.com/alura-cursos/data-science-analise-exploratoria/main/Aula_0/ml-latest-small/ratings.csv").
Isso vai retornar para nós os dados com os quais vamos trabalhar, que são as notas. Então, podemos atribuir essa expressão à variável notas e, logo em seguida, imprimir esse resultado:
notas = pd.read_csv("https://raw.githubusercontent.com/alura-cursos/data-science-analise-exploratoria/main/Aula_0/ml-latest-small/ratings.csv")
notas
Ao executar essa célula, o Google Colab abre esse arquivo da internet, carrega-o, levanta-o na memória e cria uma tabela com os dados fornecidos, sob o nome notas, além de exibir essa tabela com os campos e dados que esperávamos:
Retorno (parcialmente transcrito)
| userId | movieId | rating | timestamp |
|---|
| 1 | 1 | 4.0 | 964982703 |
| 1 | 3 | 4.0 | 964981247 |
| 1 | 6 | 4.0 | 964982224 |
| 1 | 47 | 5.0 | 964983815 |
| 1 | 50 | 5.0 | 964982931 |
| ... | ... | ... | ... |
| 610 | 166534 | 4.0 | 1493848402 |
| 610 | 168248 | 5.0 | 1493850091 |
| 610 | 168250 | 5.0 | 1494273047 |
| 610 | 168252 | 5.0 | 1493846352 |
| 610 | 170875 | 3.0 | 1493846415 |
Agora, podemos fazer muitas coisas com essas notas!
Consultando o formato da tabela
Por exemplo, podemos querer saber qual é o formato dessa tabela, ou seja, quantas linhas e colunas ela tem. Para isso, chamamos o shape, um atributo de notas, executando o seguinte código:
Conforme o retorno, temos 100.836 linhas e 4 colunas (sendo a primeira delas apenas o indexador dos registros):
Retorno
(100836, 4)
Alterando nomes de colunas
Podemos também querer alterar o nome das colunas da nossa tabela, que estão em inglês no momento.
Para isso, primeiramente chamamos a propriedade notas.columns para trazer os nomes das colunas.
Retorno
Index(['userId', 'movieId', 'rating', 'timestamp'], dtype='object')
Para alterar esses nomes, então, vamos atribuir à expressão notas.columns uma lista com os novos nomes das colunas em português: "usuarioId", "filmeId", "nota", "momento". Como é uma lista, envolvemos esses valores entre colchetes.
Depois disso, se executarmos apenas notas novamente, observaremos que trocamos o atributo colunas para os nomes das colunas em português.
Se quisermos consultar apenas uma parcela da tabela para só ter uma ideia de como está nossa tabela, podemos pedir para retornar apenas as cinco primeiras linhas (ou seja, a "cabeça" da tabela) usando o método head(), o que resulta em notas.head().
Então, executaremos a seguinte célula:
notas.columns = ["usuarioId", "filmeId", "nota", "momento"]
notas.head()
E teremos a seguinte resposta:
Retorno (parcialmente transcrito)
| usuariold | filmeId | nota | momento |
|---|
| 0 | 1 | 4.0 | 964982703 |
| 1 | 1 | 4.0 | 964981247 |
| 2 | 1 | 4.0 | 964982224 |
| 3 | 1 | 5.0 | 964983815 |
| 4 | 1 | 5.0 | 964982931 |
Consultando apenas uma coluna
Podemos fazer muito mais com esse objeto notas. Por exemplo, podemos consultar apenas uma coluna desse dataset, como a coluna nota.
Para isso, escrevemos o nome do nosso objeto notas seguido de colchetes. Dentro dos colchetes, passamos entre aspas duplas o nome da coluna desejada: nota.
O retorno será apenas os valores da coluna nota:
Retorno (parcialmente transcrito)
4.0
4.0
5.0
5.0
...
4.0
5.0
5.0
3.0
Antes tínhamos uma tabela, agora temos uma única coluna!
No Pandas, essas são coisas distintas. Quando temos a tabela, chamamos de DataFrame, ou seja, um grande quadro de dados. Quando temos uma única coluna, chamamos de Series, ou seja, uma série de dados.
Para saber o que podemos fazer com dataframes e series, é possível consultar a documentação de pandas.DataFrame e pandas.Series.
Extraindo valores únicos
Agora, queremos saber quais são as notas possíveis que as pessoas atribuem aos filmes. Ou seja, queremos saber os valores únicos dessas notas.
Para saber como fazer isso, podemos consultar a documentação — algo que faremos muito ao trabalhar com qualquer linguagem de programação. Conforme os guias, podemos aplicar o método unique() para retornar valores únicos de um objeto Series
Então, aplicaremos esse método na coluna nota do nosso objeto notas para extrair o que desejamos:
Ao executar esse código, recebemos os valores únicos dessa lista de notas:
Retorno
array([4. , 5. , 3. , 2. , 1. , 4.5, 3.5, 2.5, 0.5, 1.5])
Os valores desse array são as notas possíveis.
Você pode se perguntar se, por exemplo, a nota zero não existe, já que ela não apareceu nesse array. Mas não podemos afirmar isso com base nessa operação, já que extraímos apenas as notas que as pessoas deram, e não exatamente as possíveis. Ou seja, pode ser que a nota zero exista, mas ninguém da nossa amostra atribuiu nota zero para nenhum filme.
O mesmo vale para outros valores. Por isso, precisamos saber como a pesquisa foi realizada. São informações importantes para entender esses dados:
- Qual a escala de notas aplicada na pesquisa?
- Quais são as notas que efetivamente encontramos nos resultados?
Contando valores
Agora, queremos saber quão frequentemente aparecem cada uma dessas notas. Podemos contar esses valores usando o método value_counts().
Aplicando-o na coluna nota do nosso objeto notas, teremos:
notas["nota"].value_counts()
Retorno
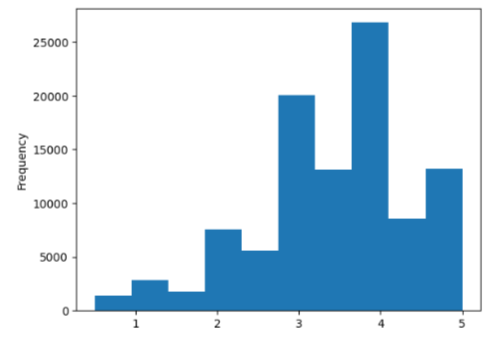
4.0  26818
3.0  20047
5.0  13211
3.5  13136
4.5  8551
2.0  7551
2.5  5550
1.0  2811
1.5  1797
0.5  1370
Ou seja: a nota 4.0 foi atribuída 26.818 vezes, e é a nota mais frequente do nosso conjunto de dados. Já a nota 0.5 foi atribuída 1.370 vezes, sendo essa a nota menos frequente.
Com isso, podemos tirar uma conclusão digna de uma real análise de dados: as pessoas não têm a tendência de atribuir notas "quebradas" ao avaliar um filme.
Além disso, também parece haver uma tendência de atribuir mais notas altas que baixas. O instrutor interpreta isso como sendo uma questão de atitude: se gastamos nosso tempo avaliando um filme, é porque ele é muito bom ou muito ruim. Algo médio geralmente não toma a nossa atenção a esse ponto.
Calculando média
Podemos também querer saber a média das notas. Para isso, usamos o método mean():
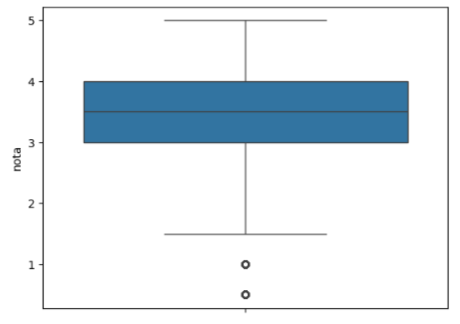
A média de todas as notas avaliadas nessa amostra é de aproximadamente 3,5 conforme o retorno desse código.
Conclusão
Repare no poder da biblioteca Pandas! Rapidamente carregamos um arquivo de dados, exploramos essa tabela, exploramos uma coluna e extraímos cálculos dela por meio de métodos precisos que o Pandas disponibiliza. Com isso, pudemos tirar conclusões iniciais acerca dos nossos dados.
Agora podemos trabalhar mais em cima disso, a partir da próxima aula. Até lá!