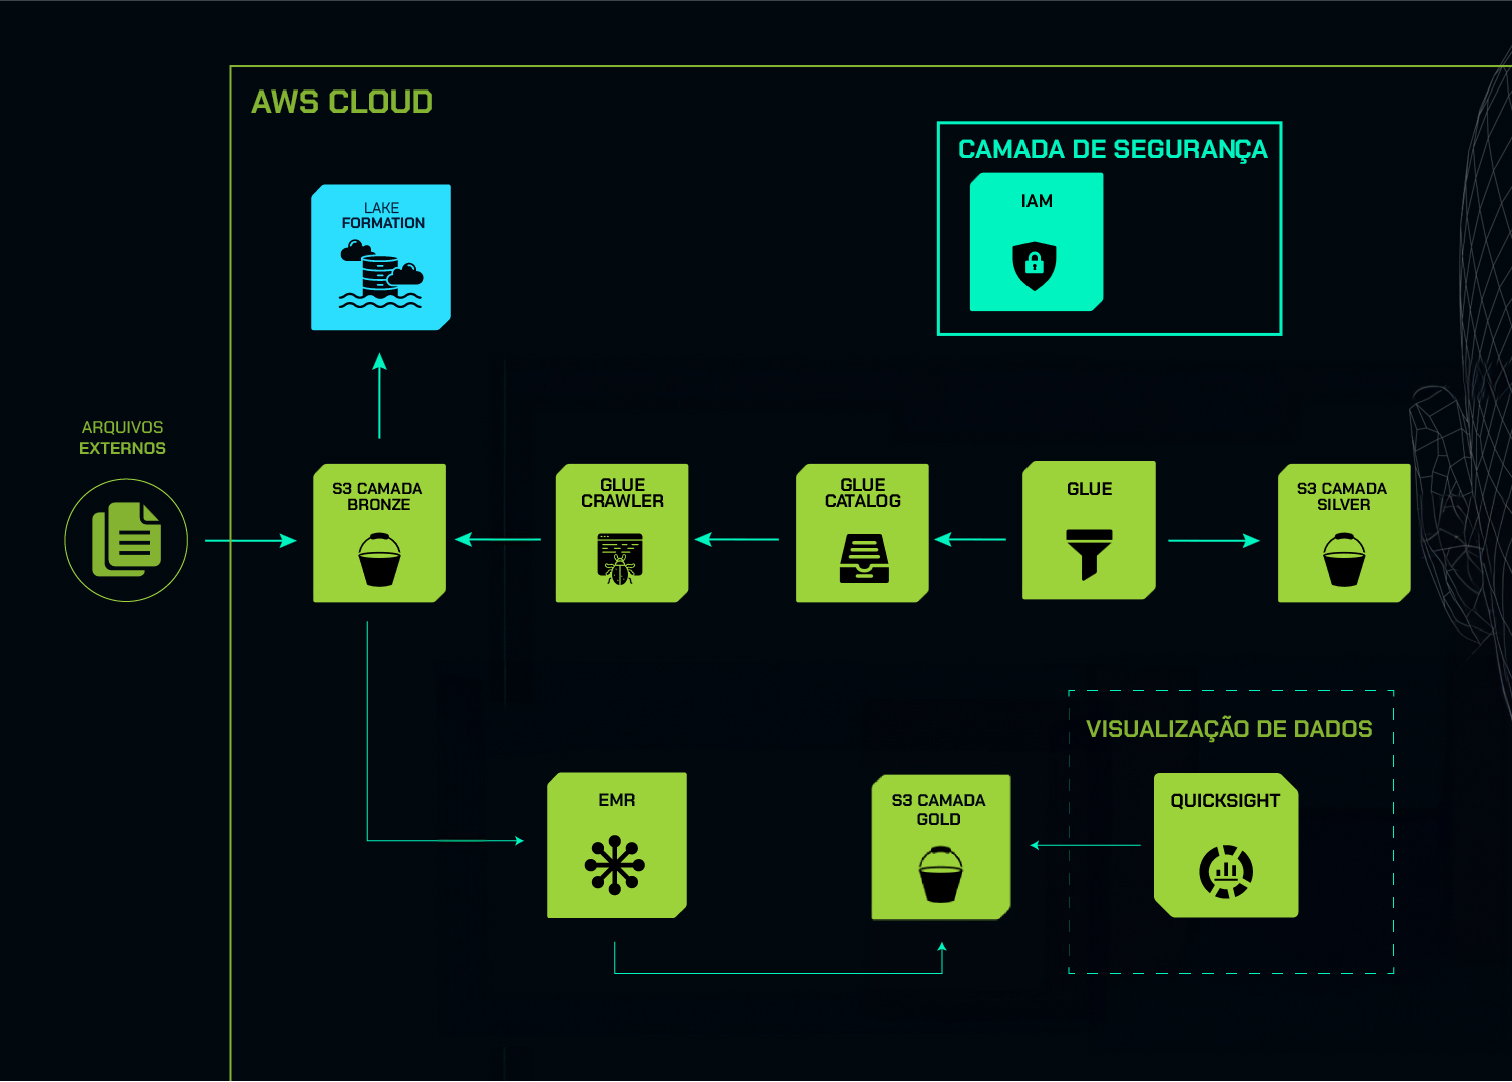
Agora que já compreendemos a arquitetura e os serviços que serão utilizados para a construção da visualização de dados com o AWS QuickSight, precisamos de uma fonte de dados para a criação do nosso dashboard.
Para isso, vamos utilizar a camada gold, que já contém as informações do site Data Boston tratadas e harmonizadas.
Executando o código EMR para criação da camada gold
Nosso desafio será reestabelecer a camada gold no Bucket S3 da AWS, pois excluímos essa camada no curso anterior.
Para resolver isso, primeiramente, vamos reestabelecer o cluster EMR e, em seguida, iremos executar o script Spark.
Nesse script, faremos a leitura da camada bronze, que contém os dados brutos do Data Boston, e no próprio script, realizaremos alguns tratamentos e harmonizações que serão salvos na camada gold.
A exclusão foi feita por ser uma boa prática excluir da AWS dados que não serão utilizados em curto ou médio prazo, de modo a evitar cobranças indevidas. Como não iríamos utilizar os dados da camada gold, fizemos a exclusão, e agora vamos reestabelecer as informações.
Clonando um cluster
Com o Console da AWS aberto, vamos buscar por "EMR" na barra de pesquisa da parte superior da tela. Na tela inicial da página "Amazon EMR", sempre aparecerão os clusters.
Nesse caso, vamos clonar o último cluster (EMR_AWSALURA), utilizado no curso anterior para executar o script Spark. Para cloná-lo, basta marcar a caixa de seleção à esquerda do nome do cluster e, em seguida, clicar no botão "Clone" no canto superior direito da tabela de clusters.
Ao clonar um cluster, a AWS sempre irá perguntar se queremos incluir os steps. Nesse caso, vamos incluir, pois foi justamente nesse step que colocamos o script Spark para ser executado.
Para isso, vamos marcar a opção "Include 1 step(s) with new cluster" e depois clicar no botão laranja "Edit configurations" no canto inferior direito da janela.
As configurações serão basicamente as que fizemos no curso anterior, pois se trata de um clone. Como essas configurações deram certo antes, não precisamos passar item a item neste vídeo, então podemos descer até o fim da tela e clicar no botão "Clone cluster" no canto inferior direito.
Analisando o step em execução
Ao fazer isso, o processo de criação do cluster será iniciado e o step será executado logo na sequência. Se clicarmos na aba "Steps" abaixo do sumário, encontraremos o step com o status pendente (Pending).
Clicando no ícone de mais (+) à esquerda da coluna "Step ID", encontraremos os argumentos:
spark-submit --deploy-mode cluster s3:
Essa é a parte principal quando executamos um script no cluster EMR, que é basicamente de onde ele obtém as informações, onde ele vai salvar, e qual script será executado. Nesse caso, ele executará o script main.py e irá salvar na camada gold na AWS.
Ao final da execução, não houve erro no status, ou seja, o script foi executado com sucesso. Basicamente, ele fez a leitura da camada bronze, conforme apontado em bronzebronze nos argumentos; depois executou o script main.py, fazendo a leitura da camada bronze; e após realizar todos os tratamentos, harmonizações e padronizações necessários, ele salvou a camada gold na AWS.
Verificando as informações na camada gold
Agora, para sabermos se o step foi executado com sucesso, podemos utilizar a AWS Athena para fazer uma consulta ad-hoc e verificar se as informações estão, de fato, na camada gold.
Lembrando que o AWS Athena, assim como o EMR, é um serviço pago, então caso não queira ter nenhuma cobrança, pedimos que você apenas acompanhe o curso e não execute na sua máquina.
Na barra de pesquisa, vamos buscar por "Athena" e clicar no primeiro link da lista. Nesse caso, já temos uma consulta salva que fizemos anteriormente:
SELECT * FROM "alura-datalakeaws"."gold" limit 10;
Basicamente, fazemos um SELECT * FROM do bucket alura-datalakeaws, e selecionamos a camada gold com limites de 10 linhas. Abaixo da consulta, conseguimos visualizar se ela foi executada com sucesso.
Na tabela "Results", ele trouxe todos os campos da camada gold. Com isso, percebemos que foi executado com sucesso.
Conclusão
Primeiramente, reestabelecemos o cluster EMR clonando um cluster que deu certo, bem como o seu step. Nesse step, passamos como argumentos tanto o script quanto o local que ele irá fazer a leitura, além do local onde serão salvas as informações. Feito isso, utilizamos a AWS Athena para fazer uma consulta na camada gold e conferir se os dados foram salvos corretamente.
Ao final, identificamos que o script foi executado com sucesso, e agora temos a camada gold para a criação do nosso dashboard no AWS QuickSight.
No próximo vídeo, aprenderemos um pouco mais sobre DataViz. Até logo!